前言
笔者近期学习了 MIT 的 6.S184 课程,将笔记整理于此。便于复习,也希望能够帮助到感兴趣的读者。
Lecture 1
Section 1
首先,我们需要建模感兴趣的目标,一个非常自然的方式就是使用 vector \(z\in \mathbb{R}^d\).
针对一副生成的图片,如何评价其生成 (Generation) 的质量呢?举个例子,prompt: “A picture of a dog”。此时模型若生成一副猫的图片,一副狗的图片;那么我们就认为,狗的图片质量优于猫。但是我们如何将这个主观认知正式建模呢?
How good an image is ~= How likely it is under the data distribution?
经过上述视角的转换,我们可以利用概率论的语言来建模生成的质量。其中,data distribution 可以通过概率密度 (Probability density) \(p_{\text{data}}: \mathbb{R}^d \rightarrow \mathbb{R}_{\geq 0}\) 来刻画。也就是,给定一个 vector \(z\),其对应的 data distribution 就是 \(p_{\text{data}}(z)\)。此时,Generation 就意味着从 \(p_{\text{data}}(z)\) 中进行采样 (sampling),即:\(z \sim p_{\text{data}}\)。
进一步拓展,当想根据需求进行生成时,即条件生成 (Conditional Generation),等价于从条件分布 (conditional data distribution) 中采样,即:\(z \sim p_{\text{data}}(\cdot\mid y)\),其中 \(y\) 表示条件。
鉴于高斯分布 (Gaussian distribution) 性质优良,在这里通常将其作为一个不错的初始化数据分布 \(p_{\text{init}}=\mathcal{N}(0, I_d)\)。因此,我们希望一个生成模型 (generative model) 将 \(x\sim p_{\text{data}}\) 转换为 \(z \sim p_{\text{data}}\)。
Section 2: Flow and Diffusion Models
Flow Models
Trajectory: 关于时间的函数,形式化为:\(X: [0,1]\rightarrow \mathbb{R}^d, t\mapsto X_t\)。含义是:将 \([0, 1]\) 时间内的任一时刻 \(t\) 都对应着某一个状态的 vector \(X_t\)。举个例子,生成过程中的 image,已经初具模样但未达到 \(z\) 的质量。
Vector Field: \(u: \mathbb{R}^d\times [0,1]\rightarrow \mathbb{R}^d, (x, t)\mapsto u_t(x)\)。含义是:将某一个状态和时刻映射到另一个状态。
Orginary Differential Equation (ODE):
- Initialization: 定义了 Trajectory 的起始点,形式化为:\(X_0=x_0\);
- Evolution: 说明了 Trajectory 应该如何演变,形式化为:\(\frac{d}{d t}X_t=u_t(x)\).
Flow: 以任何可能的 $x_0$ 作为起始点的 Trajectory;形式化为:\(\psi: \mathbb{R}^d\times [0,1]\rightarrow \mathbb{R}^d, (x_0, t)\mapsto \psi_t(x_0)\)。即:
- Initialization: \(\psi_0(x_0) = x_0\);
- Evolution: \(\frac{d}{d t}\psi_t=u_t(\psi_t(x_0))\).
在机器学习领域,我们希望/假设 ODE 解的唯一性和存在性是成立的。
假设 $d=1, u_t(x)=2\sqrt{x}, X_0=x_0$. 那么有:该 ODE 解不唯一.
Proof. \(X_t\) 表示粒子在 \(t\) 时刻的状态 (或者说: $d$ 维坐标),因此在 vector field $u_t(x)$ 中,想要知道粒子在 \(t\) 时刻的 “速度” ($dX_t / dt$),其实就是粒子所处状态 (坐标) 的 “速度”,即: $u_t(X_t)$。
依题意得, $\frac{d}{dt} X_t = u_t(X_t) = 2\sqrt{X_t}$. 分离变量可以得到: $\frac{dX_t}{\sqrt{X_t}}=2dt$. 将 $dt$ 更换成 $d\tau$ 表示任一时刻,并且由于 $t\geq 0$,所以确定积分上下限(令 $u=X_\tau$ 进行变量替换);因此得到: $\int_{x_0}^{X_t} \frac{du}{\sqrt{u}}=\int_{0}^{t} 2d\tau$. 两边同时积分可得: $2\sqrt{u}\mid_{x_0}^{X_t}=\tau^2\mid_{0}^{t}$,即:$2(\sqrt{X_t}-\sqrt{x_0})=2t$ 化简可得: $X_t=(t+\sqrt{x_0})^2$.
回顾一下上述例子,除了 “ODE 解不一定唯一” 之外,有个更细节的等式需要我们注意:$\underline{u_t(X_t)}=\frac{dX_t}{dt}=\underline{u_t(x)}$.
Flow Model:
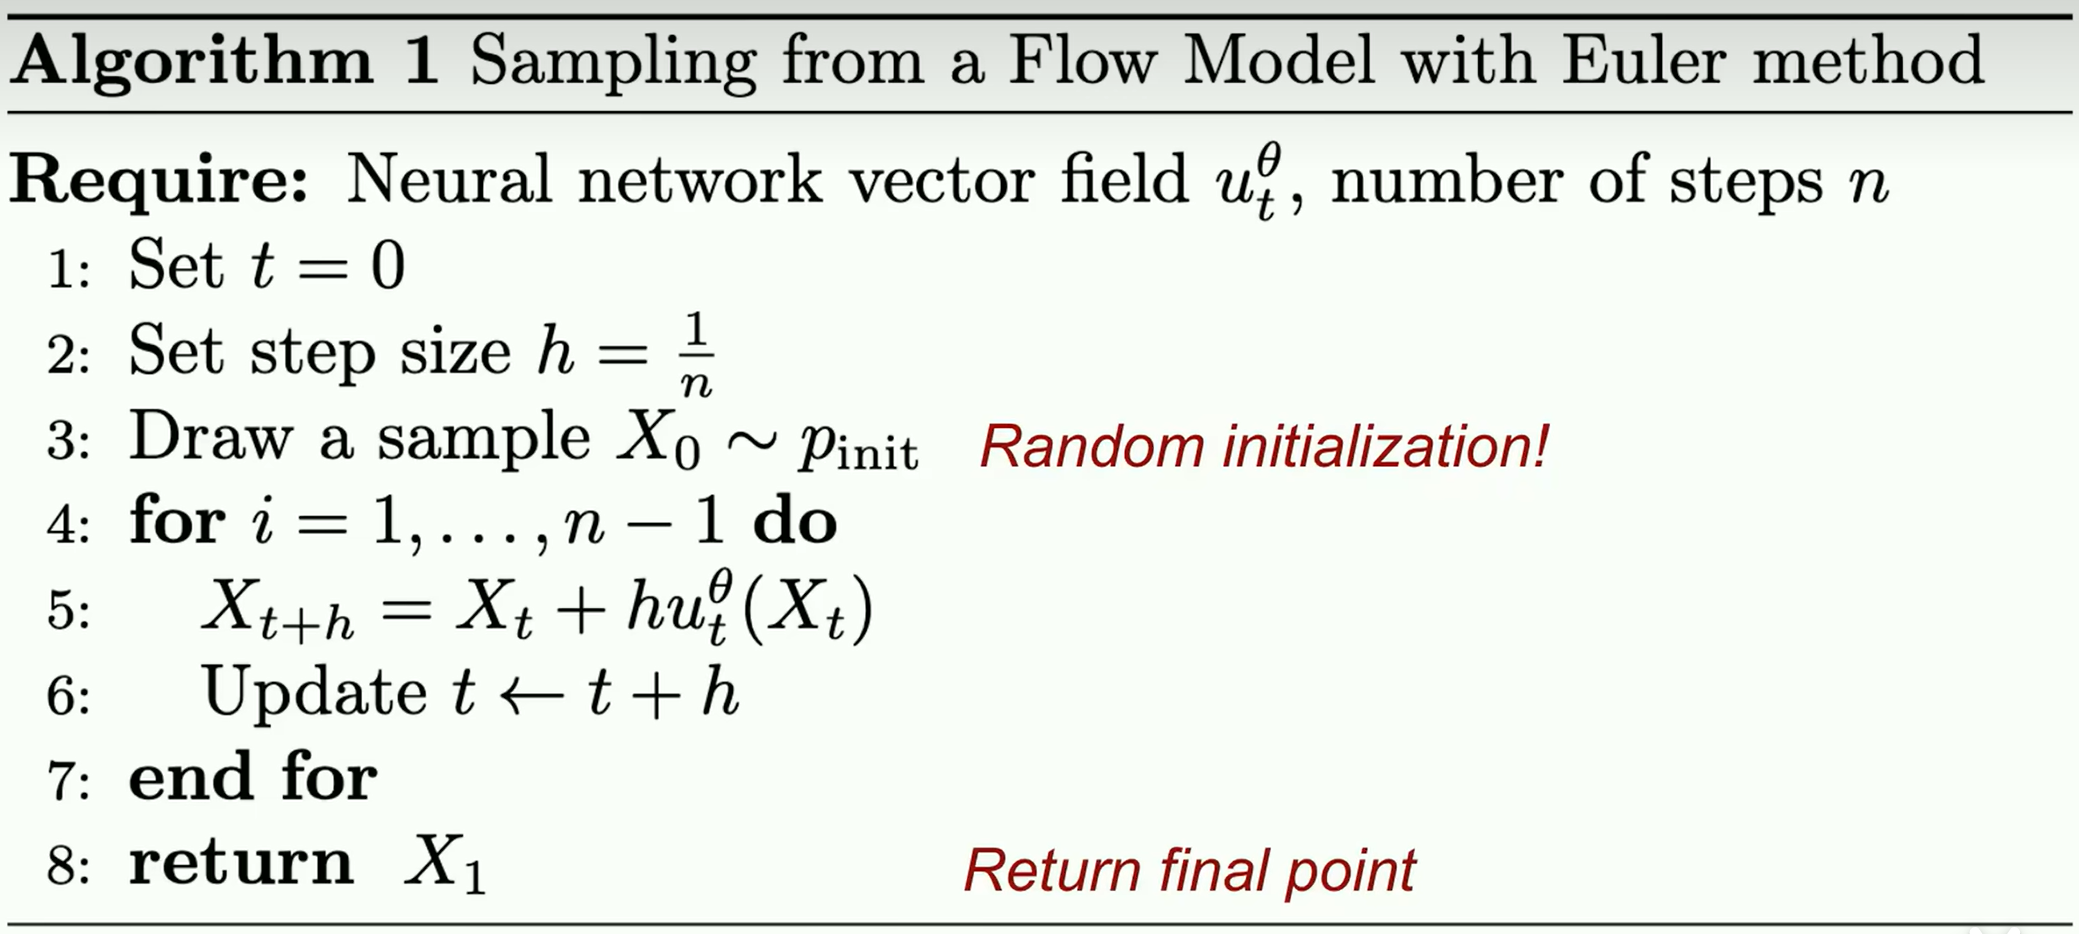
- Neural Network: $u_t^\theta: \mathbb{R}^d\times [0,1] \to \mathbb{R}^d$, where $\theta\in \mathbb{R}^k$ 表示神经网络的参数;
- Random initialization: $X_0\sim p_{\text{init}}=\mathcal{N}(0, I_d)$;
- ODE: $\frac{d}{d t}X_t=u_t^{\theta}(x)$;
- Goal: $X_1\sim p_{\text{data}}$.
Diffusion Models
Stochastic Process: \(X:[0,1]\to \mathbb{R}^d\) but it is a random variable,其含义为:一个随机过程可以产生多条 Trajectories。
vector field: \(u_t(x)\)
Diffusion coefficient: \(\sigma: [0,1]\to \mathbb{R}_{\geq 0}, t\mapsto \sigma_t\)。其含义是:任一时刻 \(t\),模型含有多少 “随机性”/“噪声” (非负;
Stodchastic Differential Equation (SDE):
- Initialization: \(\psi_0(x_0) = x_0\);
-
Evolution: \(dX_t=\underbrace{u_t(X_t) dt}_{\text{ODE Part}} + \underbrace{\sigma_tdW_t}_{\text{Stochasitic Part}}\),其中 \(W_t\) 表示布朗运动 (Brownian motion)。
-
Brownian motion:
-
\(W_0=\boldsymbol{0}\);
-
Gaussian increments: 取两个时刻 \(t\geq s\), 有:\(W_t - W_s \sim \mathcal{N}(0, (t-s) I_d)\);
-
Independent increments: 任意两个 increments 都是相互独立的;
-
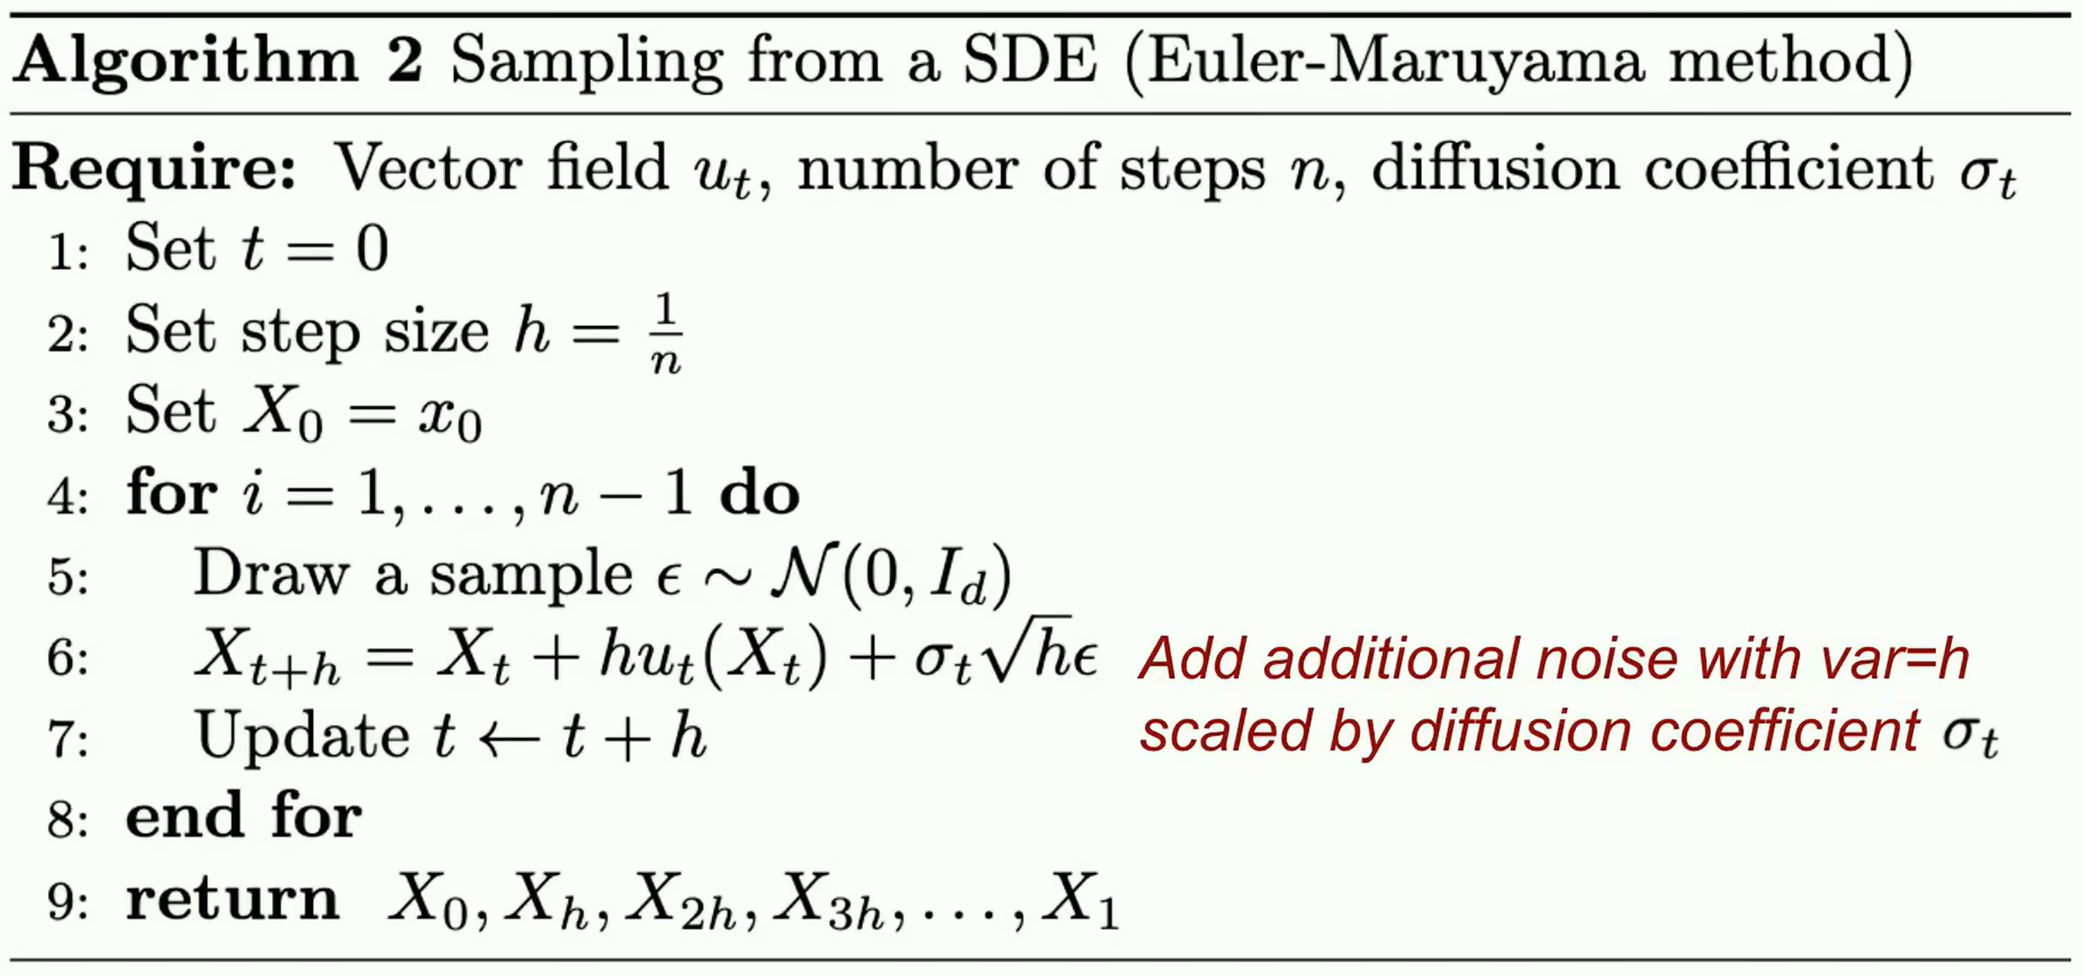
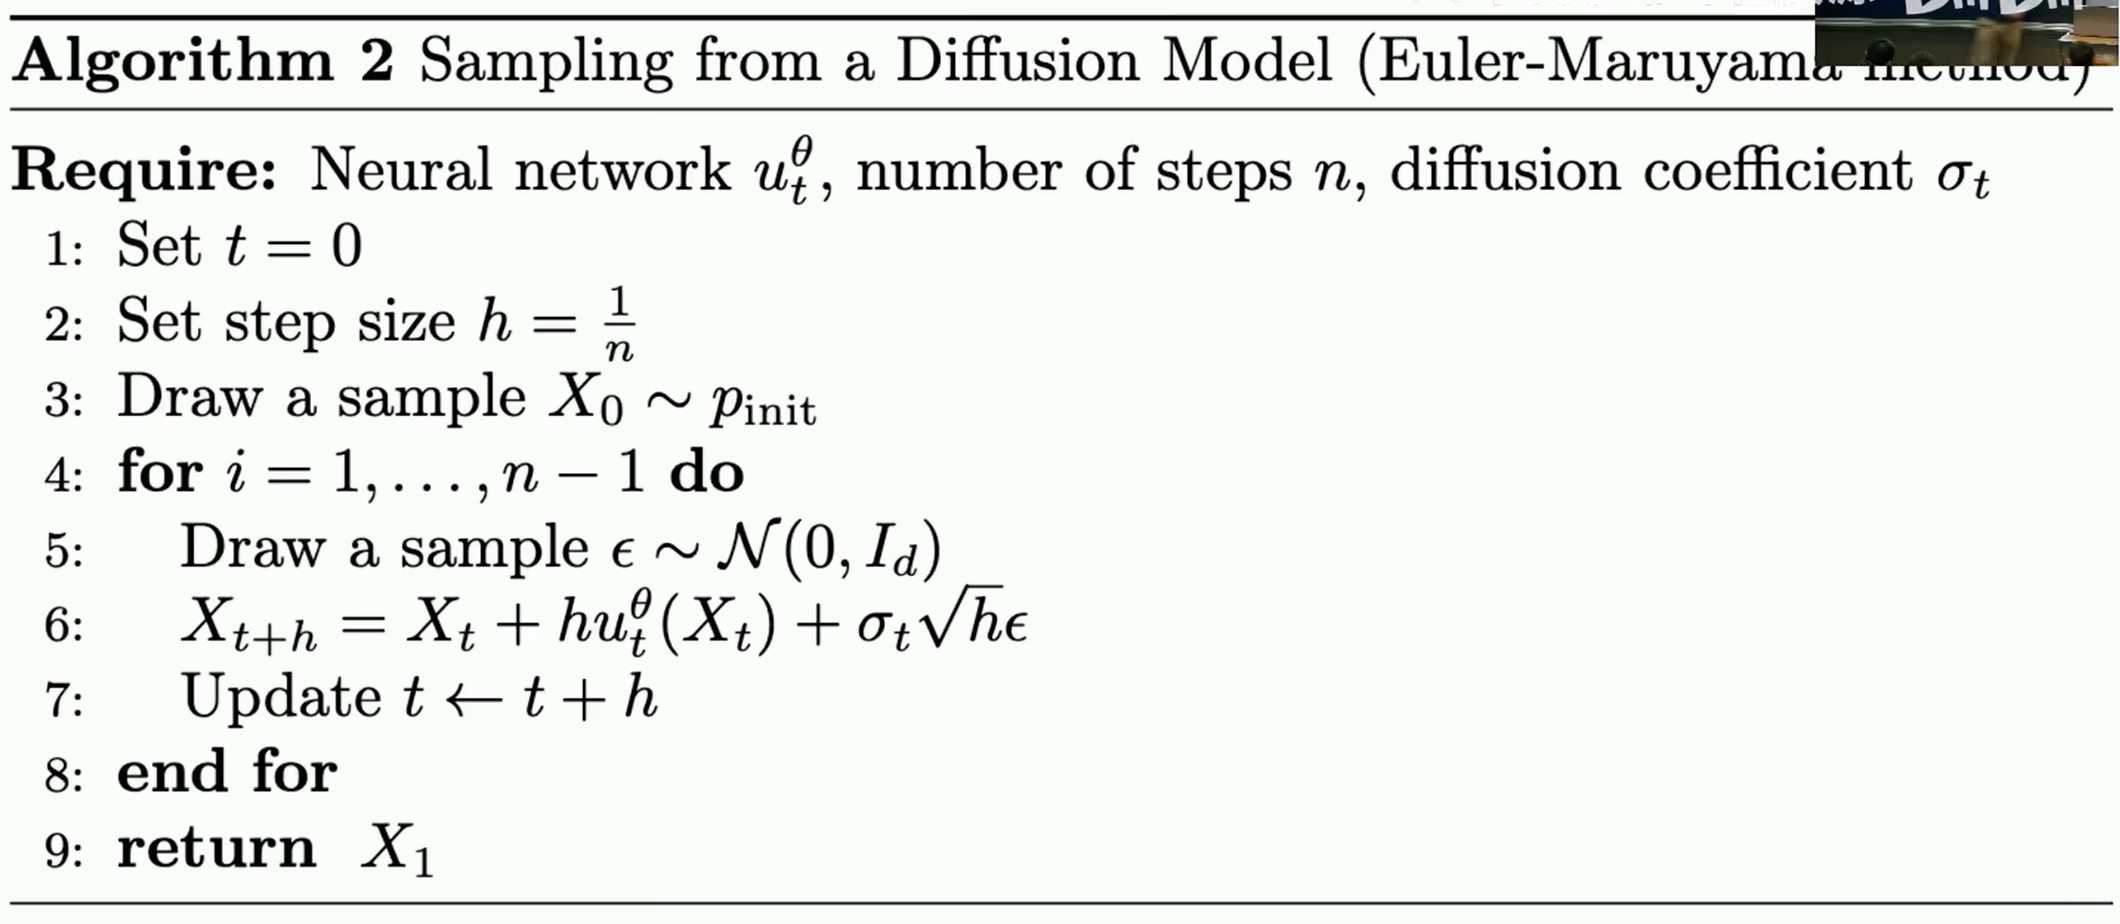
Simulation: 上述是形式化定义,实际上我们仅需 \(W_{t+h}=W_t+\sqrt{h}\epsilon\), where \(\epsilon\sim \mathcal{N}(0, I_d)\), \(h\) 是 update stepsize. 注意,这里之所以是 $\sqrt{h}$,原因在于要保持 Brownian motion 的 Gaussian increments 性质。
-
考虑到 Brownian motion 不可导,和 ODE/SDE 的现有形式无法很好结合;因此将 ODE、SDE 改写成适合直接结合 $W_t$ 的形式(利用导数的极限定义,将微分转换成差分):
-
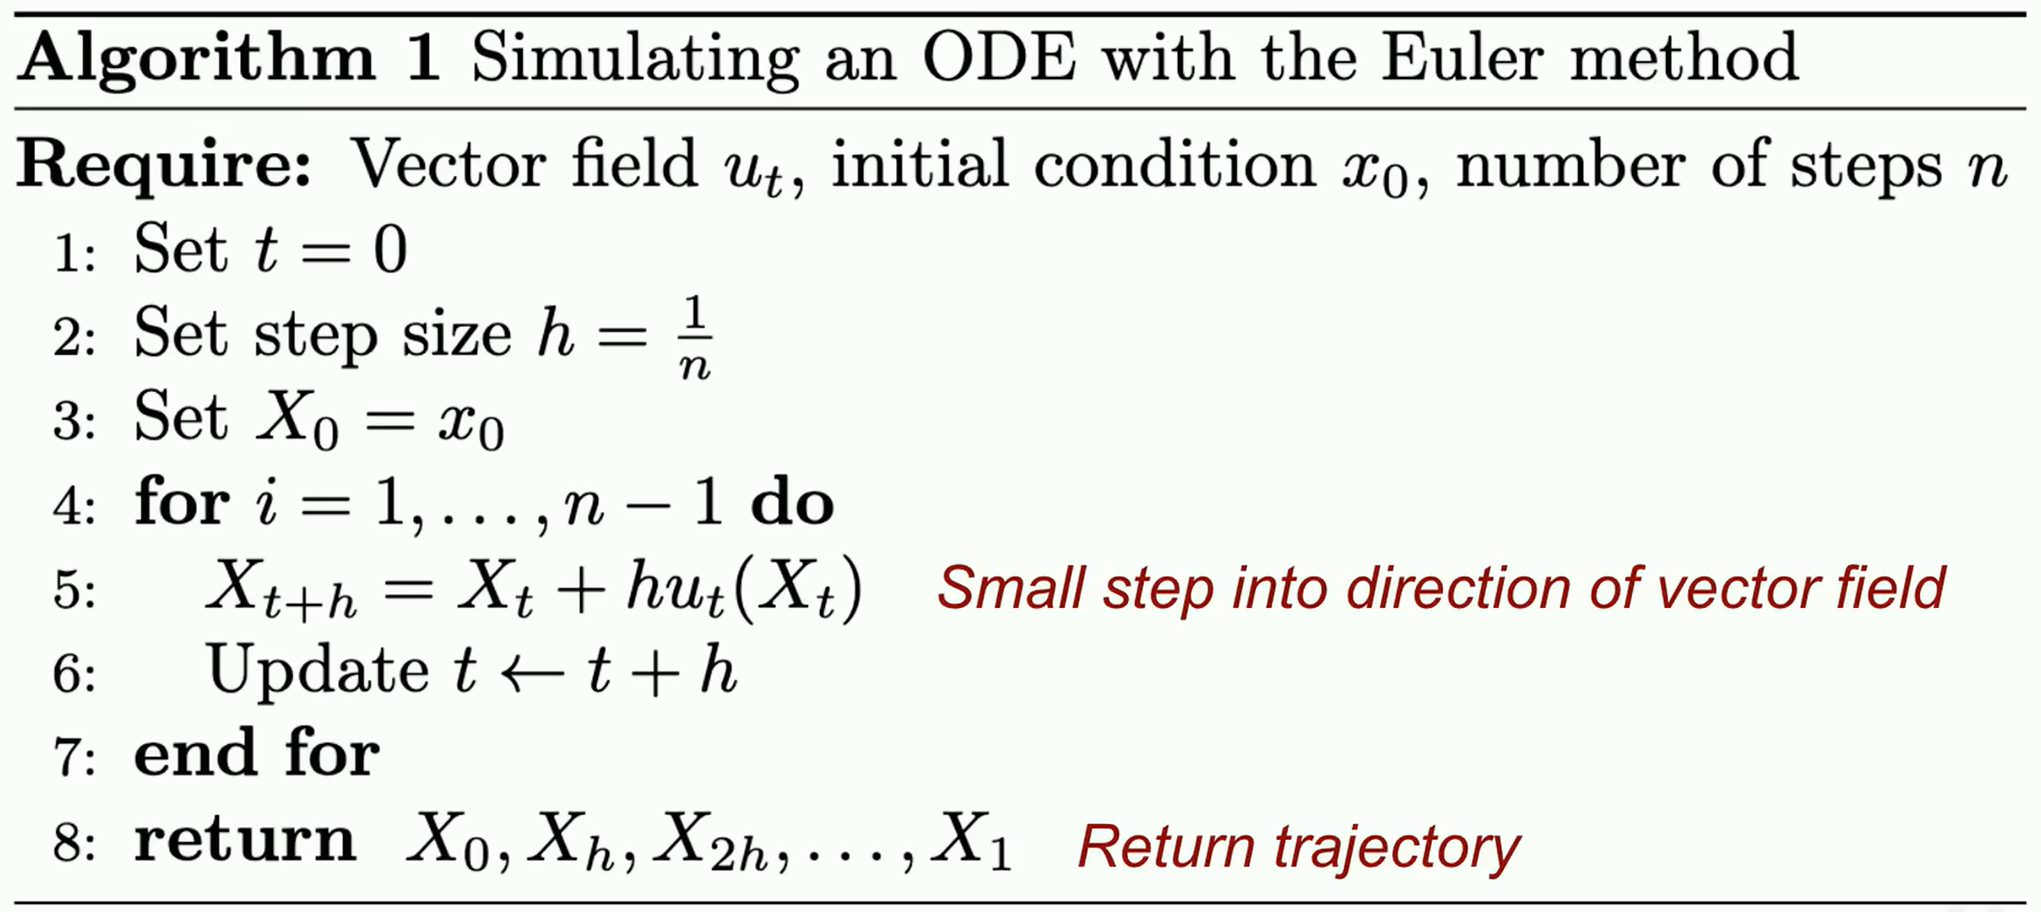
ODE: \(dX_t=u_t^{\theta}(X_t) dt \iff X_{t+h}-X_t = h\cdot u_t^{\theta}(X_t).\)
-
SDE: \(dX_t=u_t^{\theta}(X_t) dt + \sigma_tdW_t \iff X_{t+h}-X_t = h u_t^{\theta}(X_t) + \sigma_t (W_{t+h}-W_t).\) 之后再对 Brownian motion 进行 simulation 可得:\(X_{t+h}-X_t = h u_t^{\theta}(X_t) + \sigma_t \sqrt{h} \epsilon\).
注意:上述转换之后都会存在误差项 \(R_t(h)\),但是 \(\lim_{h\to 0} \frac{R_t(h)}{h} = 0\) 可被忽略掉。
Diffusion Model:
- Neural Network: \(u_t^\theta: \mathbb{R}^d\times [0,1] \to \mathbb{R}^d\), where \(\theta\in \mathbb{R}^k\) 表示神经网络的参数;
- Random initialization: \(X_0\sim p_{\text{init}}=\mathcal{N}(0, I_d)\);
- SDE: \(dX_t=u_t^{\theta}(X_t) dt + \sigma_tdW_t\);
- Goal: \(X_1\sim p_{\text{data}}\).
Lecture 2
书接上文。现在我们明确了 Flow Model 和 Diffusion Model,也知道了对应的 Goal。那么,如何达到这个目标呢?这就是我们在这一讲要解决的核心问题。
Flow Matching
Probability Path
Dirac Distribution: 概率密度完全集中在唯一的点 \(z\) 之上的分布,形式化定义为:\(\delta_z: X\sim \delta_z \iff X=z\). 其含义是,在 \(\delta_z\) 分布采样总是且只可能得到同个 sample \(z\);
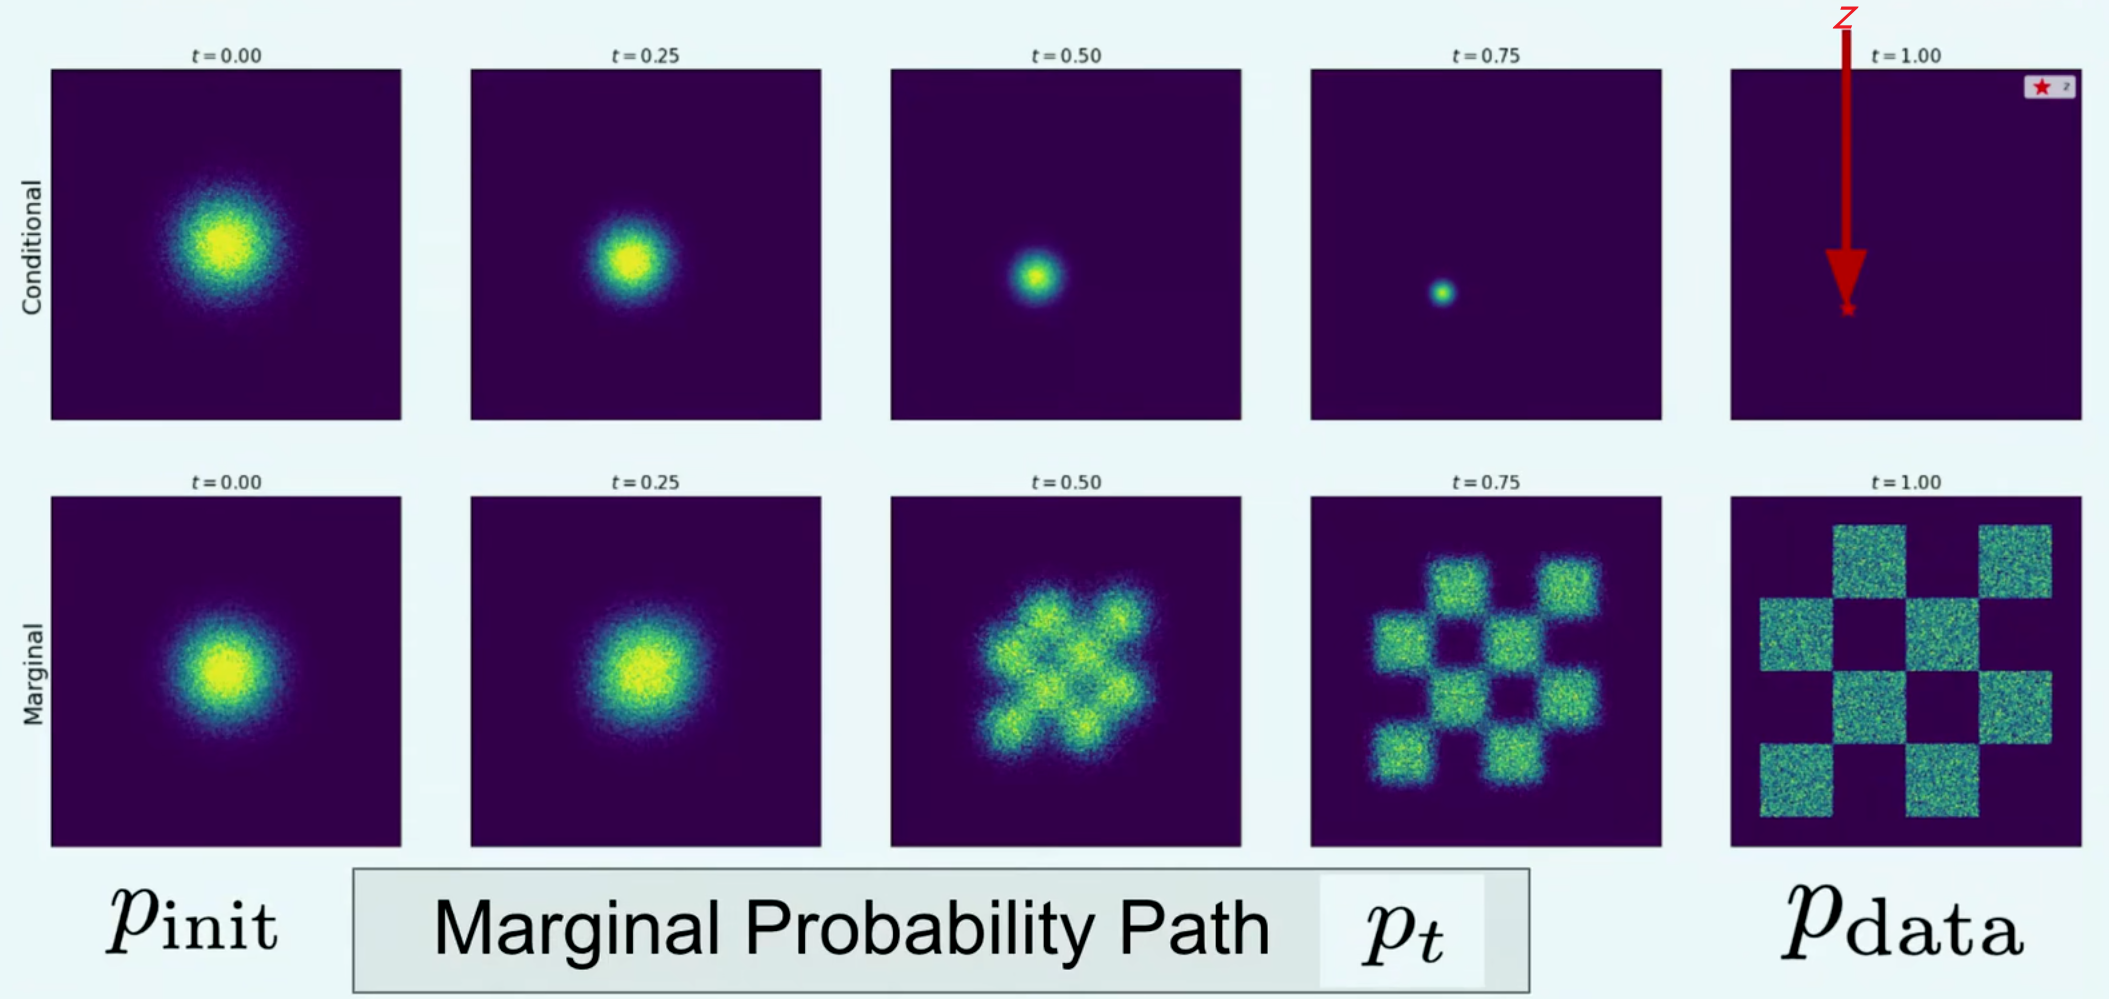
Conditional Probability Path: \(p_t(x\mid z)\) 其中 \(t\in[0,1], x,z\in \mathbb{R}^d\); 其含义是:\(p_{\text{init}}\) 和 \(p_{\text{data}}\) 这两个分布之间的 “插值”,或者可以理解为中间状态?
-
\(p_t(\cdot \mid z)\) is a distribution;
这是因为,我们希望用概率密度来描述粒子所处位置;因此在某一时刻 \(t\),给定条件 \(z\),粒子所有可能出现的位置的概率之和应该为 \(1\),也就意味着 \(p_t(\cdot \mid z)\) 是个概率密度分布。
-
\(p_0(\cdot\mid z)=p_{\text{init}}\);
生成的开始应该是不包含任何信息,即与 \(z\) 无关的。
-
\(p_1(\cdot\mid z)=\delta_z\).
利用 Dirac distribution 的 “概率密度集中” 的性质,确保最终生成的目标能够收敛到期望的结果 \(z\)。
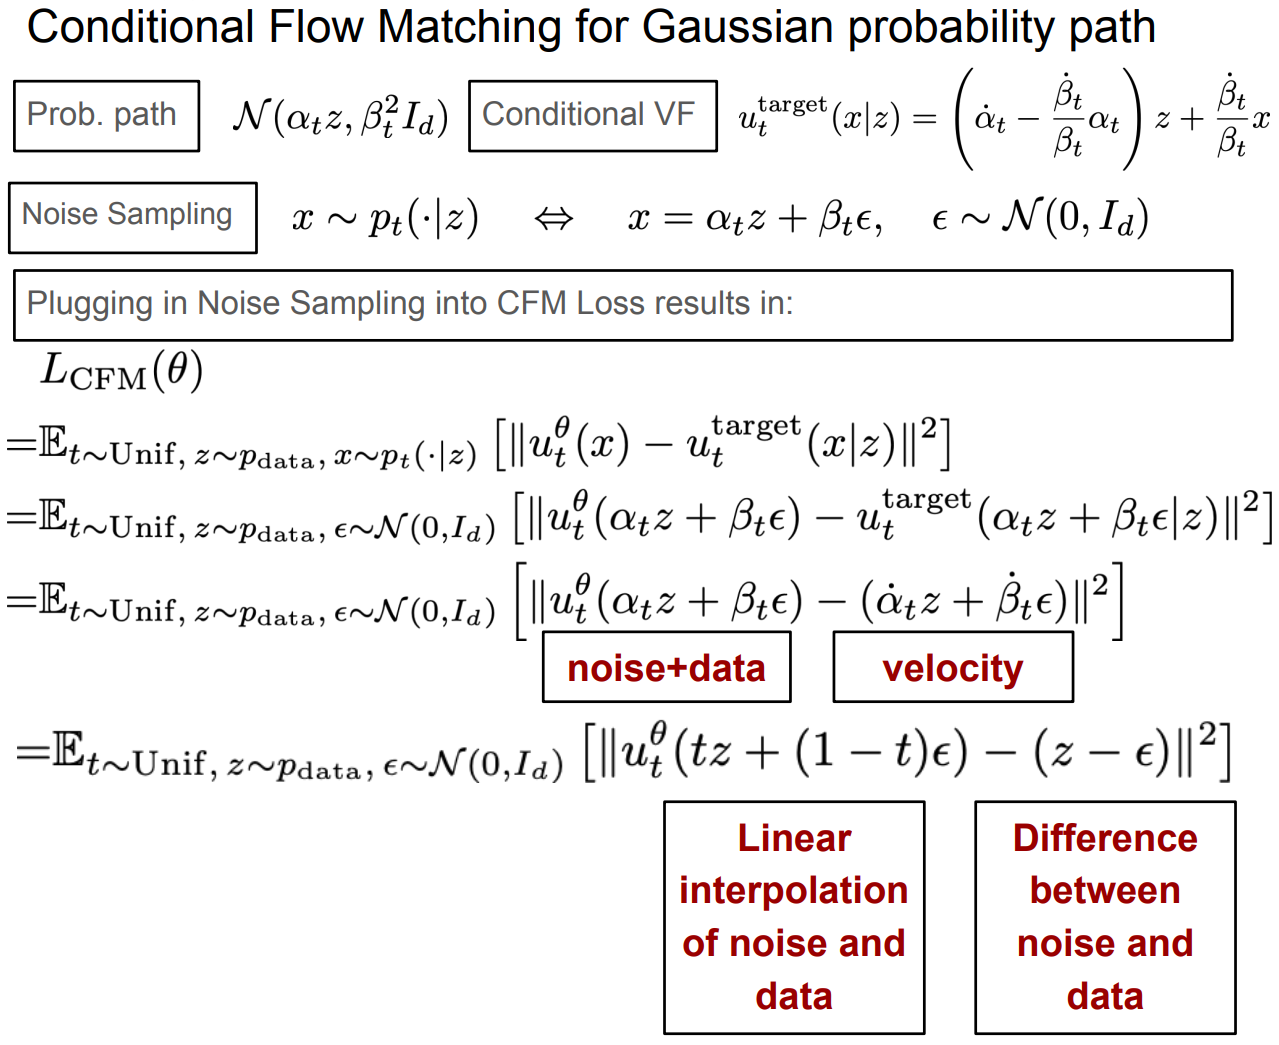
Specific Conditional Probability Path——Gaussian: $p_t(\cdot \mid z)=\mathcal{N}(\alpha_t z, \beta_t^2 I_d)$, 其中 $\alpha_t, \beta_t \in \mathbb{R}$ 即可,可以自己设计,只要满足上述三个约束即可。课程给的是 $\alpha_t=t, \beta_t=1-t$,下面进行上述约束的检验。
- Gaussian distribution $\mathcal{N}(\alpha_t z, \beta_t^2 I_d)$ 自然是一个分布;
- $p_0(\cdot \mid z)=\mathcal{N}(t z, (1-t)^2 I_d)=\mathcal{N}(0, I_d)$ 正是 $p_{\text{init}}$;
- $p_1(\cdot \mid z)=\mathcal{N}(t z, (1-t)^2 I_d)=\mathcal{N}(z, \boldsymbol{0})$, 均值为 \(z\), 方差为 $\boldsymbol{0}$ 正是收敛到 \(z\) 上。
Marginal Probability Path: \(p_t(x)=\int p_t(x\mid z)p_{\text{data}}(z)dz\),其含义是:批量处理一堆点,其中每个点 \(z\sim p_{\text{data}}\).
- \(p_0(\cdot)=p_{\text{init}}\);
根据 Conditional Prob Path, 针对单个点 \(z\), 在 $t=0$ 起始时刻都是从 \(p_{\text{data}}\) 中采样,那么批量采样的时候自然是 \(= p_{\text{init}}\)。
- \(p_1=p_{\text{data}}\).
根据 Conditional Prob Path, 针对单个点 \(z\), 在 $t=1$ 时刻都是收敛到对应的点 \(z\) 处;又因为 $z\sim p_{\text{data}}$, 自然有:$p_1=p_{\text{data}}$。
Vector Field
Conditional vector field: $u_t^{\text{target}}(x\mid z)\in \mathbb{R}^d$.
根据连续性方程/Fokker-Planck 方程: \(\begin{align} X_0\sim p_{\text{init}}, dX_t=u_t^\text{target}(X_t\mid z)dt\implies X_t\sim p_t(x\mid z). \end{align}\) 这里自然会有个疑问,conditional vector field $u_t^{\text{target}}(x\mid z)$ 有什么用呢?我们暂且将其记住,等下再来回答。
Marginal vector field:
\[\begin{align} u_t^{\text{target}}(x)=\int u_t^{\text{target}}(x\mid z) \frac{p_t(x\mid z)p_{\text{data}}}{p_t(x)}dz \label{def:marginal_vector_field}. \end{align}\]Marginalization Trick:
\[\begin{align} X_0\sim p_{\text{init}}, dX_t=u_t^\text{target}(X_t)dt\implies X_t\sim p_t. \label{eq:marginalization_trick} \end{align}\]这里我们真正关心的是,$X_1\sim p_1 = p_\text{data}$。
ok,现在我们可以来回答前面的疑问 “conditional vector field $u_t^{\text{target}}(x\mid z)$ 有什么用呢”:我们通过 Eq. ($\ref{def:marginal_vector_field}$) 连接到 Marginal vector field $u_t^{\text{target}}(x)$,进而利用 Eq. ($\ref{eq:marginalization_trick}$), 通过 simulate the ODE 就可以确保 $X_1\sim p_{\text{data}}$ (the specific case of $X_t\sim p_t$),即生成的样本服从目标数据分布!
Proof of Marginalization Trick
已知定理: 给定 $X_0\sim p_{\text{init}}, \frac{d}{d t}X_t=u_t(x)$, 有:
\[\begin{align} X_t\sim p_t \iff \underbrace{\frac{d}{d t}p_t(x) = -\textbf{div}(p_t u_t)(x)}_{\text{Continuity Equation}}. \end{align}\]其中 $\text{div } v_t(x)=\sum_i \frac{\partial}{\partial x_i} (v_t(x))_i$ 表示散度。因此,我们想要证明 Marginalization Trick 中 $X_t\sim p_t$,等价于证明 Continuity Equation 成立。
因此有:
\[\begin{align} \frac{d}{d t}p_t(x) &= \frac{d}{d t} \int p_t(x\mid z)p_{\text{data}}(z)dz——\text{根据 Prob Path 的定义} \\ &= \int \frac{d}{d t} p_t(x\mid z)p_{\text{data}}(z)dz——\text{根据算子的线性} \\ &= \int \underbrace{\frac{d}{d t} p_t(x\mid z)}_{\text{有 Continuity Equation 成立}} p_{\text{data}}(z)dz——\text{已知 $X_t\sim p_t(x\mid z)$, 再利用上述定理.} \\ &= \int \underbrace{-\textbf{div}\left(p_t(x\mid z) u_t^{\text{target}}(x\mid z)\right)(x)}_{\text{Continuity Equation}} \cdot p_{\text{data}}(z)dz \\ &= -\textbf{div}\left(\int p_t(x\mid z) u_t^{\text{target}}(x\mid z) \cdot p_{\text{data}}(z)dz\right)(x)——\text{根据算子的线性} \\ &= -\textbf{div}\left(p_t(x)\underbrace{\int u_t^{\text{target}}(x\mid z) \cdot \frac{p_t(x\mid z)p_{\text{data}}(z)}{p_t(x)} dz}_{\text{正是 Marginal vector field 的定义}}\right)(x)——\text{乘除同一项并整理} \\ &= -\textbf{div}\left(p_t(x) u_t^{\text{target}}(x)\right)(x) \end{align}\]观察等式头尾,我们发现 $p_t(x)$ 同样满足 Continuity Equation。根据定理,也就意味着 $X_t\sim p_t$ 成立。
这里 Conditional Prob Path 之所以满足 Continuity Equation,是因为 $p_t(x\mid z), v_t(x\mid z)$ 是基于我们人为构造出来的 Trajectory $X_t$ 得到的;而在构造 “足够好” 的 $X_t$ 的时候,自动保证 Continuity Equation 成立!
我们是基于 Conditional Prob Path 满足 Continuity Equation,推导出 Marginal Prob Path 也满足 Continuity Equation;进而通过上述定理,桥接到 $X_t\sim p_t$。
Flow Matching
利用 Marginalization Trick,只要知道 $u_t^\text{target}(x)$,随着 $t\to 1$ 就可以得到 $X_1\sim p_{\text{data}}$。因此有目标: $u_t^\theta \approx u_t^\text{target}$. 因此可以得到下述直观的 Flow Matching Loss.
Flow Matching Loss:
\[\begin{align} \mathcal{L}_{FM}(\theta)=\mathbb{E}_{t\sim \text{Unif}[0,1], x\sim p_t(\cdot\mid z)}\left[ \|u_t^\theta(x) - u_t^\text{target}(x) \|^2 \right]. \end{align}\]上述思路很理想,然而 $u_t^\text{target}(x)$ 是 untractable 的!见 Eq. ($\ref{def:marginal_vector_field}$),其中后验部分难以处理!既然 $u_t^\text{target}(x)$ 难以处理,我们将其更换为 conditional vector field $u_t^{\text{target}}(x\mid z)$,得到 conditional flow matching loss 如下:
Conditional FM Loss:
\[\begin{align} \mathcal{L}_{CFM}(\theta)=\mathbb{E}_{t\sim \text{Unif}[0,1], z\sim p_{\text{data}}, x\sim p_t(\cdot\mid z)}\left[ \|u_t^\theta(x) - u_t^\text{target}(x\mid z) \|^2 \right]. \end{align}\]很好,现在该损失是 tractable 的了,但是它的最优解 $u_t^{\theta^\star}(x)$ 还能够尽可能逼近 $u_t^\text{target}(x)$ 吗?下述定理完美回答了我们的困扰。
Theorem:
\[\begin{align} \mathcal{L}_{FM}(\theta) = \mathcal{L}_{CFM}(\theta) + \text{Constant}. \end{align}\]Proof. 首先将 $|\boldsymbol{a}-\boldsymbol{b}|^2=|\boldsymbol{a}|^2+|\boldsymbol{b}|^2-2\boldsymbol{a}^\top \boldsymbol{b}$ 分别代入 \(\mathcal{L}_{FM}(\theta)\) 和 \(\mathcal{L}_{CFM}(\theta)\) 得到:
\[\begin{align} \mathcal{L}_{FM}(\theta)=\mathbb{E}_{t, x} \left[ \underbrace{\bcancel{\|u_t^\theta(x)\|^2}}_{\text{两式相等删去}} +\underbrace{\cancel{\|u_t^\text{target}(x) \|^2}}_{\text{对} \theta \text{而言是 Constant, 被吸收}} - 2 (u_t^\theta(x))^\top u_t^\text{target}(x) \right], \\ \mathcal{L}_{CFM}(\theta)=\mathbb{E}_{t, z, x} \left[ \underbrace{\bcancel{\|u_t^\theta(x)\|^2}}_{\text{两式相等删去}} + \underbrace{\cancel{\|u_t^\text{target}(x\mid z) \|^2}}_{\text{对} \theta \text{而言是 Constant, 被吸收}} - 2 (u_t^\theta(x))^\top u_t^\text{target}(x\mid z) \right], \end{align}\]因此聚焦在对比交叉项:
\[\begin{align} &\mathbb{E}_{t,x}\left[(u_t^\theta(x))^\top u_t^\text{target}(x)\right] \\ = &\mathbb{E}_{t,x}\left[(u_t^\theta(x))^\top \int u_t^{\text{target}}(x\mid z) \frac{p_t(x\mid z)p_{\text{data}}(z)}{p_t(x)}dz\right] \\ = &\int_x \int_z (u^\theta(x))^\top u^{\text{target}}(x|z) \frac{p_t(x\mid z)p_{\text{data}}(z)}{\cancel{p_t(x)}} \cancel{p_t(x)} dz dx \\ = &\int_z \int_x (u^\theta(x))^\top u^{\text{target}}(x|z) p_t(x,z) dx dz \\ = &\mathbb{E}_{t,z,x}\left[ (u_t^\theta(x))^\top u_t^\text{target}(x\mid z) \right] \end{align}\]综上,所以有:两个损失相差一个常数项的关系式成立。
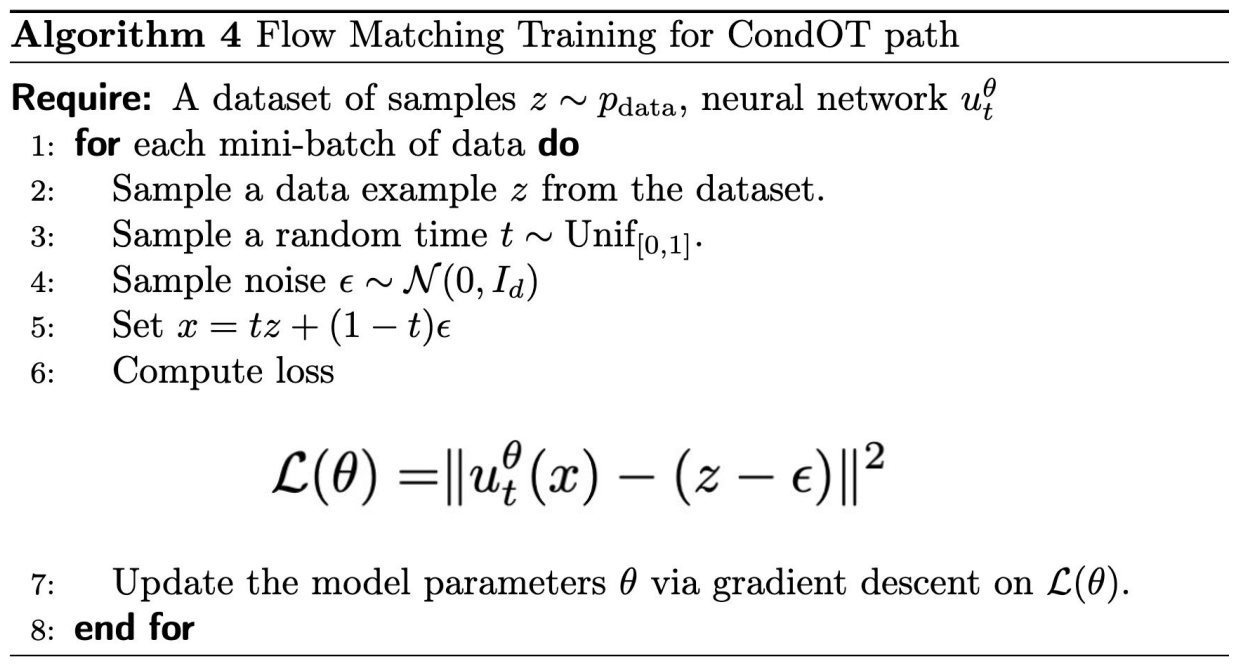
ok 现在我们就可以得到下述算法。
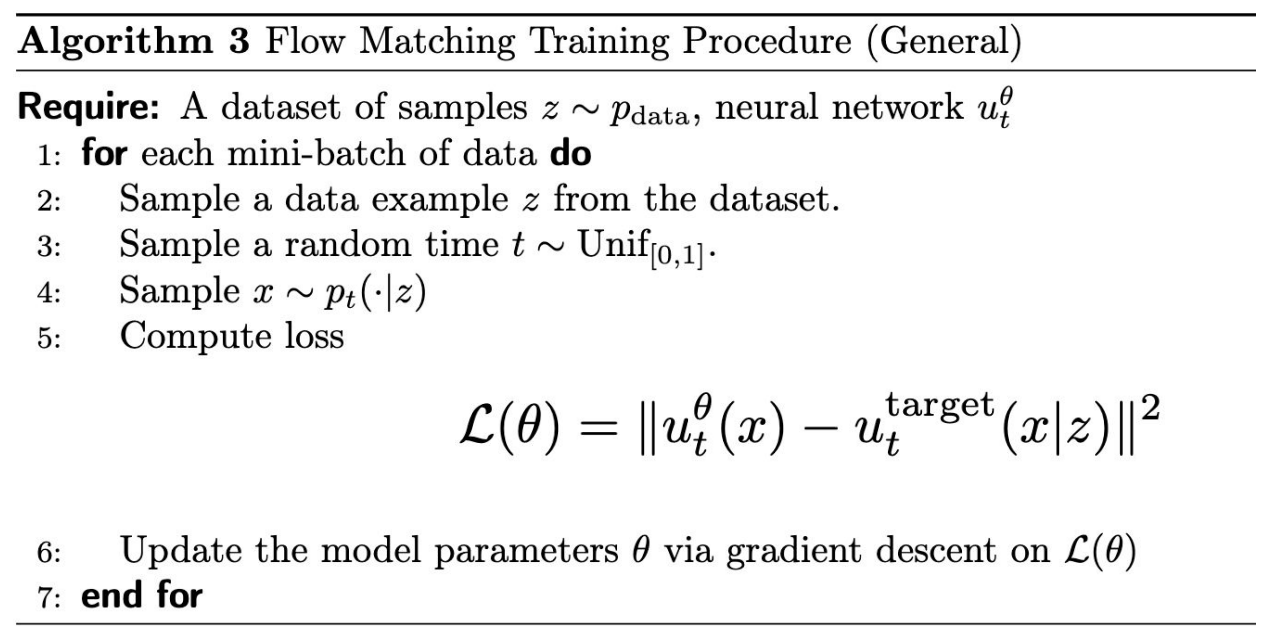
因此有一个特定的算法如下: