前言
笔者近期学习了 MIT 的 6.S184 课程,将笔记整理于此。便于复习,也希望能够帮助到感兴趣的读者。
Lecture 5
Latenr Space
当我们想要生成图像/音频/视频等模态,其通常是超高维度的。举个例子,\(\underbrace{1000}_{\text{width}}\times \underbrace{600}_{\text{height}}\times \underbrace{3}_{\text{RGB channels}}\) 的图片, 拉成一维向量 (因为 flow matching/diffusion 学习的对象 \(u_t^\theta: \mathbb{R}^d \to \mathbb{R}^d\) 针对的是一维向量) 之后,\(d=1,800,000\)。而这会带来问题。
Why is high-dimensional space is a problem for diffusion models and not for supervised learning?
- 学习 vector filed $u_t^\theta: \mathbb{R}^d \to \mathbb{R}^d$, 其输出维度和输入维度一致;
- 在模拟 ODE 时需要前向多步, 带来误差的累计以及效率地大幅降低.
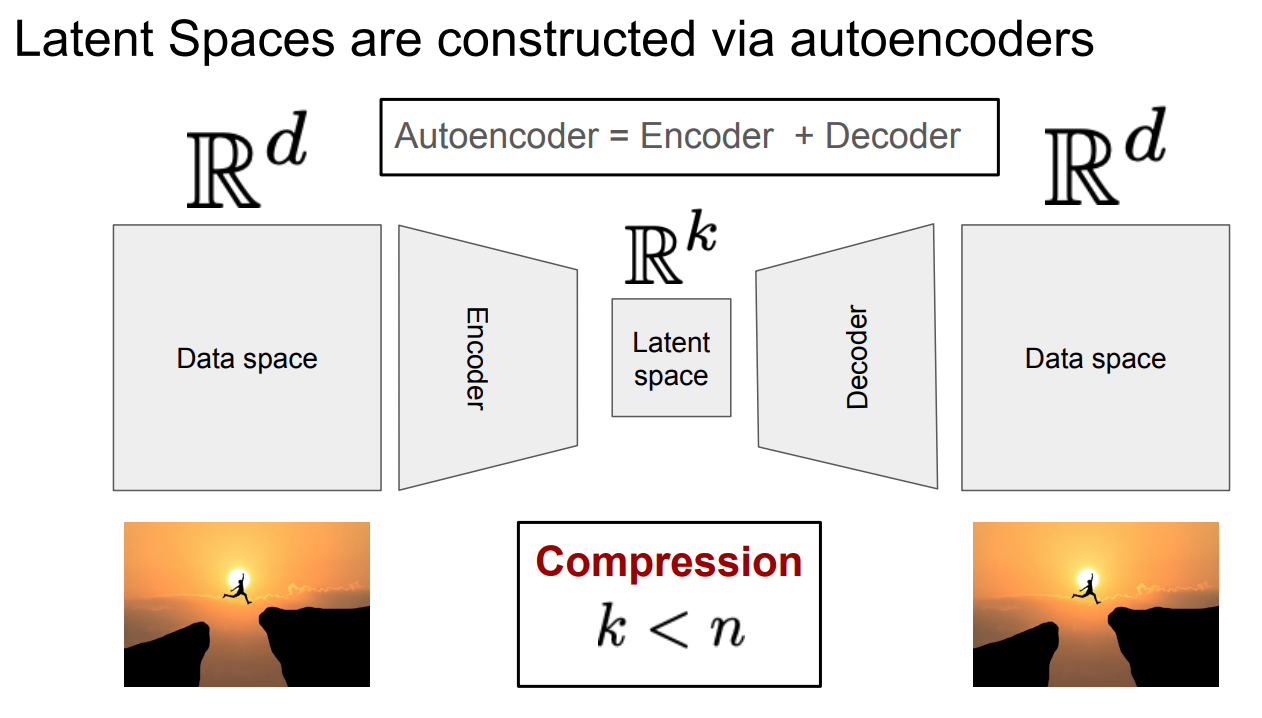
Standard Autoencoders
首先我们定义:
| 定义 | 形式化定义 |
|---|---|
| Latent embedding/feature | $z\in \mathbb{R}^k$ |
| Data point | $x\in \mathbb{R}^d$ |
| Encoder | $\mu_{\phi}: \mathbb{R}^d \to \mathbb{R}^k$ |
| Dncoder | $\mu_{\theta}: \mathbb{R}^k \to \mathbb{R}^d$ |
Reconstruction Loss:
\[\begin{align} \mathcal{L}_{}(\phi, \theta) = \mathbb{E}_{x\sim p_{\text{data}}}\left[ \left\|\mu_{\theta}\left(\underbrace{\mu_{\phi}(x)}_{z\sim p_{\text{Latent}}}\right) - x\right\|^2 \right] \end{align}\]利用上述 Reconstruction Loss 确实能够有效压缩 $x$,只要确保 $k<d$。但是这里存在问题,将 $x$ 编码成 $z$ 之后,$z\sim p_{\text{Latent}}$ 这里的 $p_{\text{Latent}}$ 是什么样子?我们无法知道。但是我们希望他的形状是优良的。
Variation Autoencoders (VAE)
| 定义 | 形式化定义 |
|---|---|
| (Stochastic) Encoder | $q_{\phi}(z\mid x)=\mathcal{N}(z; \mu_{\phi}(x),\sigma_{\phi}^2 I_k)$ |
| (Stochastic) Dncoder | $p_\theta(x\mid z)=\mathcal{N}(x; \mu_{\theta}(z), \sigma^2 I_d)$ |
现在,我们得到的 latent embedding 就是直接从 Encoder 中进行采样 $z\sim q_{\phi}(\cdot\mid x)$. 同理就有 $x\sim p_{\theta}(\cdot\mid z)$.
VAE Reconstruction Loss:
\[\begin{align} \mathcal{L}_{Recon}(\phi, \theta) &= \mathbb{E}_{x\sim p_{\text{data}},z\sim p_{\phi}(\cdot\mid x)}\left[-\log p_\theta(x\mid z)\right] \\ &= \mathbb{E}_{x\sim p_{\text{data}},z\sim p_{\phi}(\cdot\mid x)}\left[\frac{1}{2\sigma^2}\left\|x - \mu_\theta(z) \right\|^2 \right]——\text{代入 Gaussian distribution.} \end{align}\]该损失项的作用是:确保能够 reconstruction 出来, 如 $x - \mu_\theta(z)$ 所示。
VAE Prior Loss:
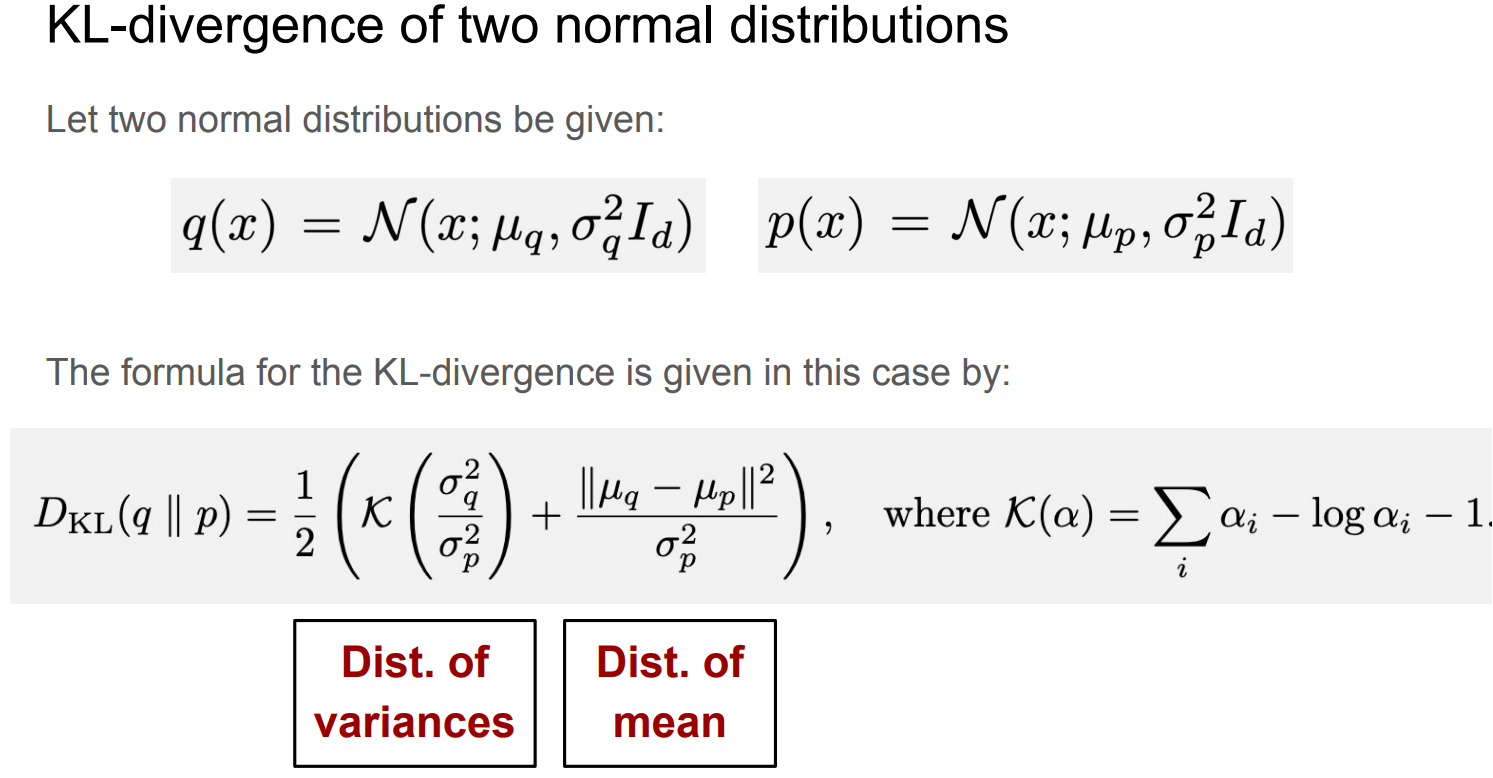
\[\begin{align} \mathcal{L}_{Prior}(\phi) &= \mathbb{E}_{x\sim p_{\text{data}}}\left[D_{KL}\left(q_\phi(\cdot\mid x) \| \mathcal{N}(0, I_k)\right)\right] \\ &= \mathbb{E}_{x\sim p_{\text{data}}}\left[\frac{1}{2}\left(\mathcal{K}\left(\frac{\sigma_\phi^2}{1^2}\right) + \frac{\|\mu_\phi-0\|^2}{1^2}\right) \right]——\text{利用两个 Gaussian Distribution 的 KL 散度计算公式} \end{align}\]该损失项的作用是:确保 latent embedding/feature 具备优良形状——即和 standard gaussian distribution 一致。
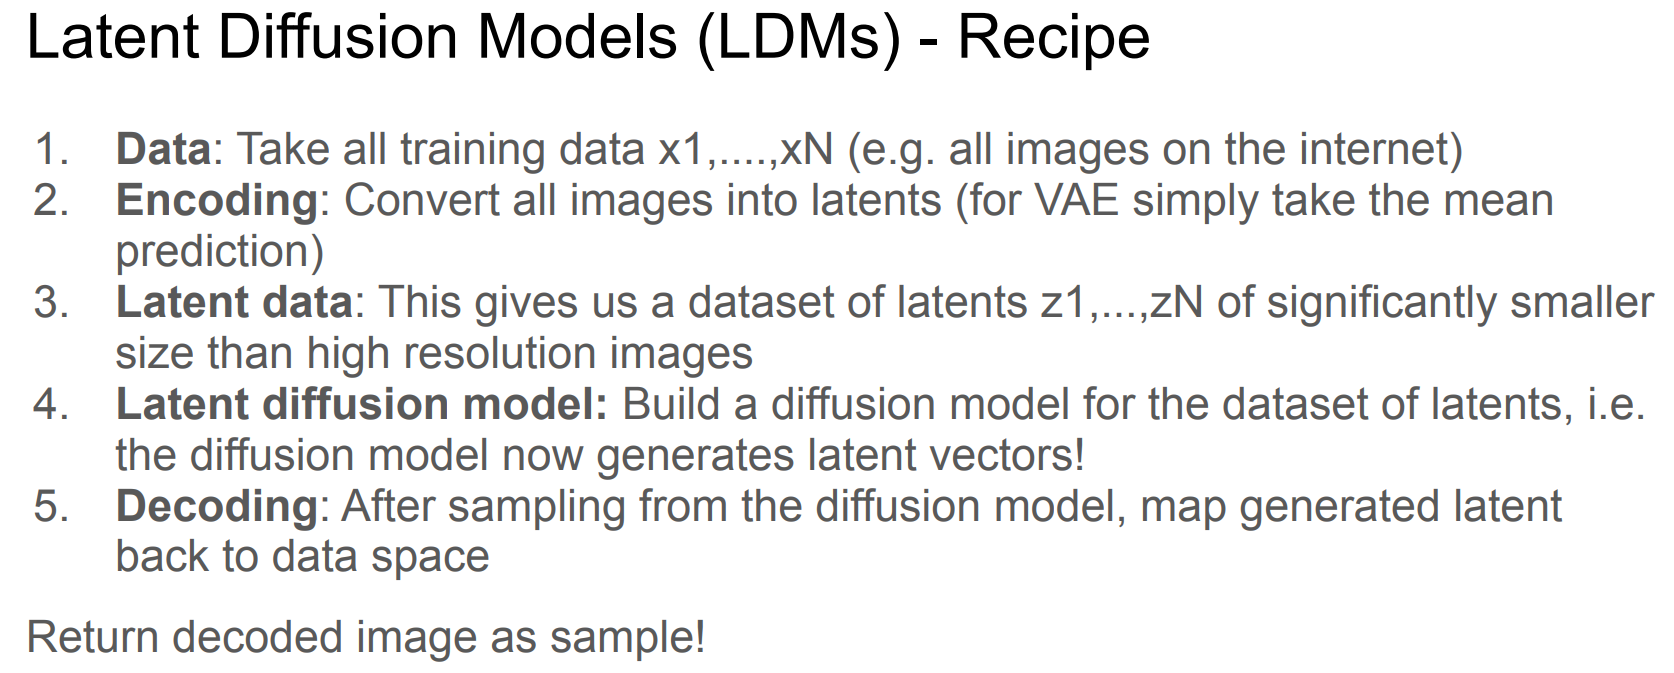
VAE Loss:
\[\begin{align} \mathcal{L}_{VAE}(\phi) &= \mathcal{L}_{Recon}(\phi) + \beta\cdot \mathcal{L}_{Prior}(\phi) \\ &= \mathbb{E}_{x\sim p_{\text{data}},z\sim p_{\phi}(\cdot\mid x)} \left[ \frac{1}{2\sigma^2}\left\|x - \mu_\theta(z) \right\|^2 + \frac{\beta}{2}\left(\mathcal{K}\left(\sigma_\phi^2\right) + \|\mu_\phi\|^2\right) \right]. \end{align}\]上述 Loss 在理论上已经足够好,但存在问题:$z\sim p_{\phi}(\cdot\mid x)$。这里 “采样” 是怎么做到的呢?如何让梯度能够流通过去呢?答案是:Reparameterization Trick: $\epsilon\sim \mathcal{N}(0, I_k), z=\mu_\phi(\cdot\mid x) + \sigma_\phi \cdot \epsilon \iff z\sim p_{\phi}(\cdot\mid x)$。最终我们可以得到:
\[\begin{align} \mathcal{L}_{VAE}(\phi) &= \mathbb{E}_{x\sim p_{\text{data}},\textcolor{red}{\epsilon\sim \mathcal{N}(0, I_k)}} \left[ \frac{1}{2\sigma^2}\left\|x - \mu_\theta\left(\underbrace{\textcolor{red}{\mu_\phi(\cdot\mid x) + \sigma_\phi^2\cdot \epsilon}}_{z}\right) \right\|^2 + \frac{\beta}{2}\left(\mathcal{K}\left(\sigma_\phi^2\right) + \|\mu_\phi\|^2\right) \right]. \end{align}\]综上,我们有 VAE 算法,利用它就可以训练出足够好的 Encoder、Decoder。
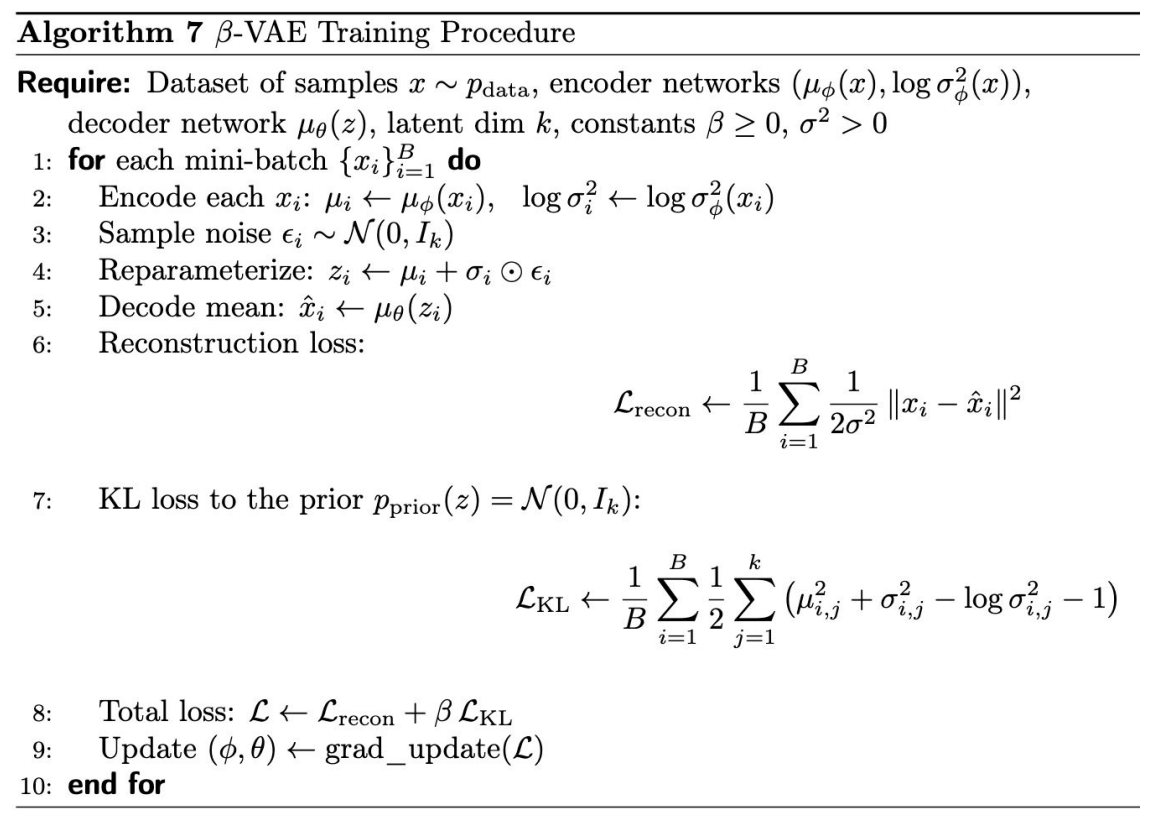
Latent Diffusion Models
利用前文算法训练出来的 Encoder、Decoder,即可实现 Latent Diffusion Models.
Neural Network Architecture
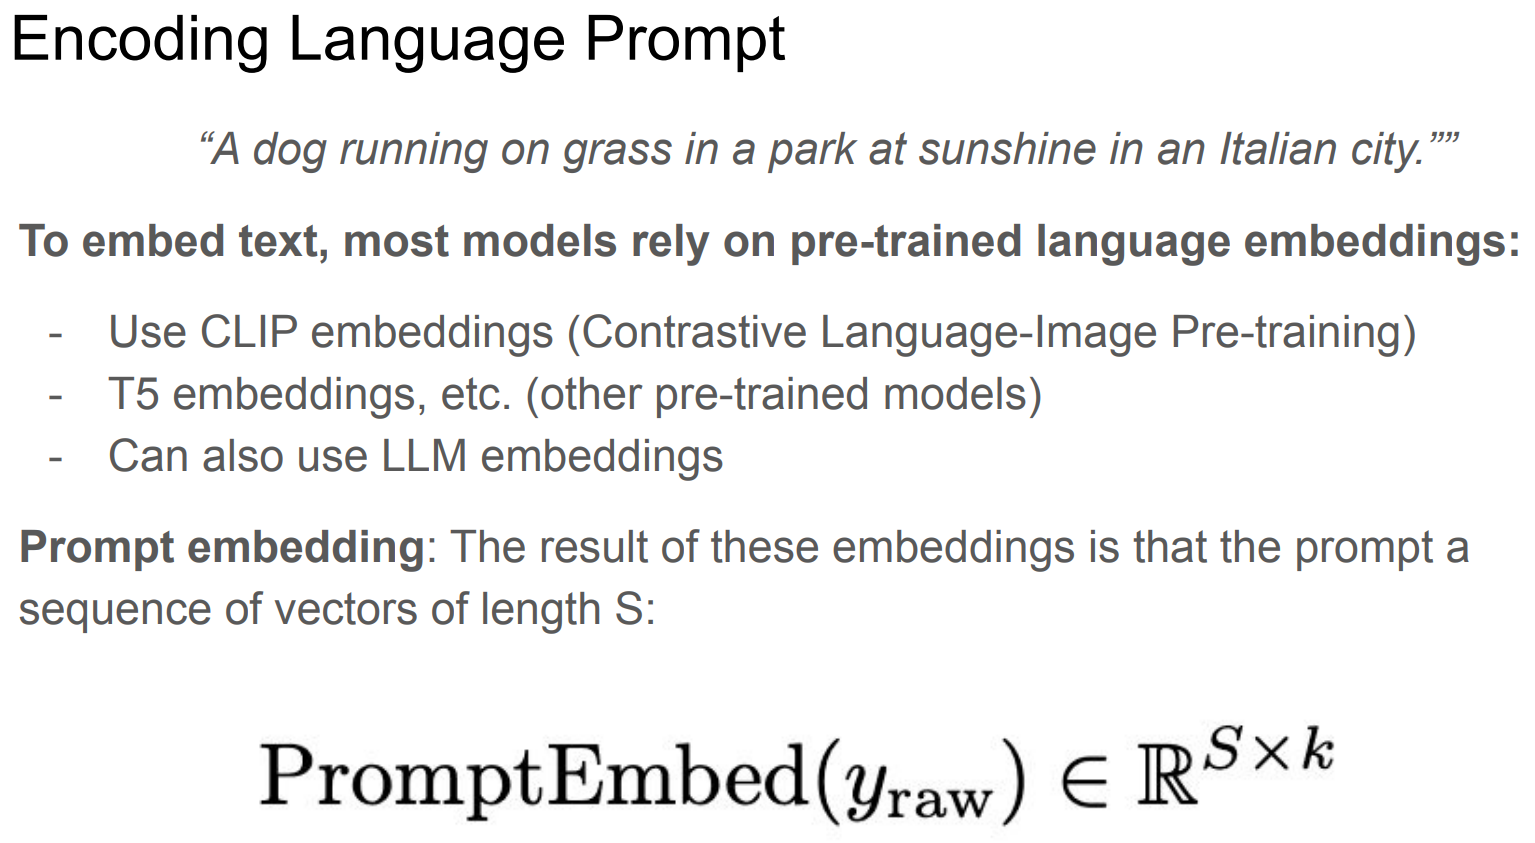
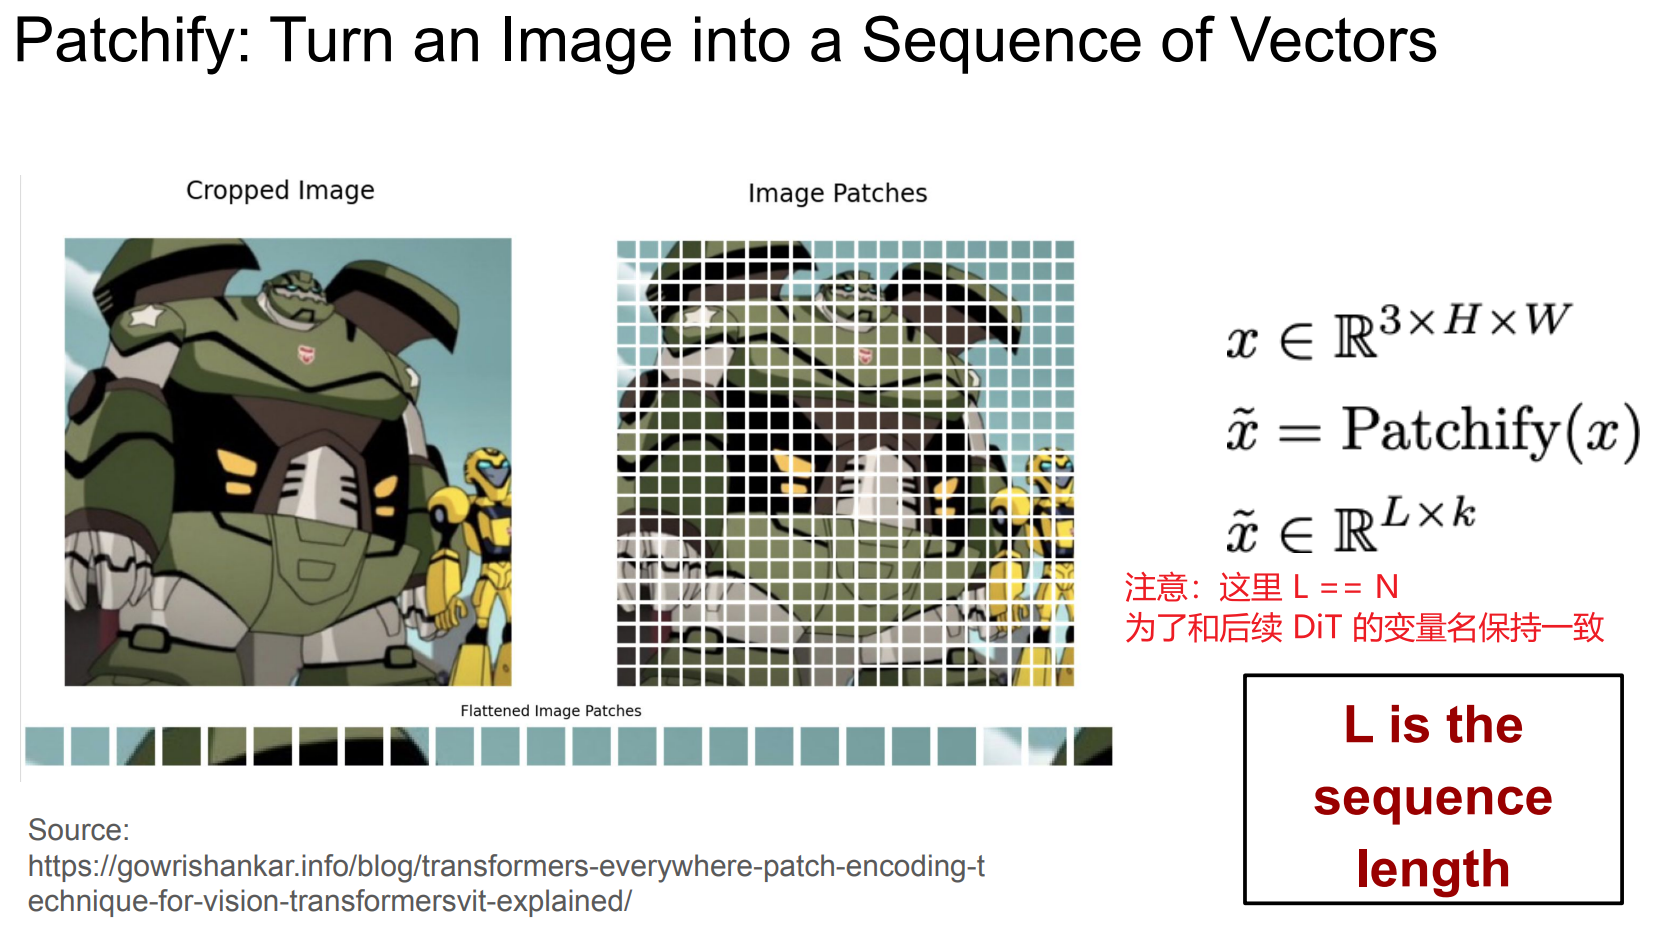
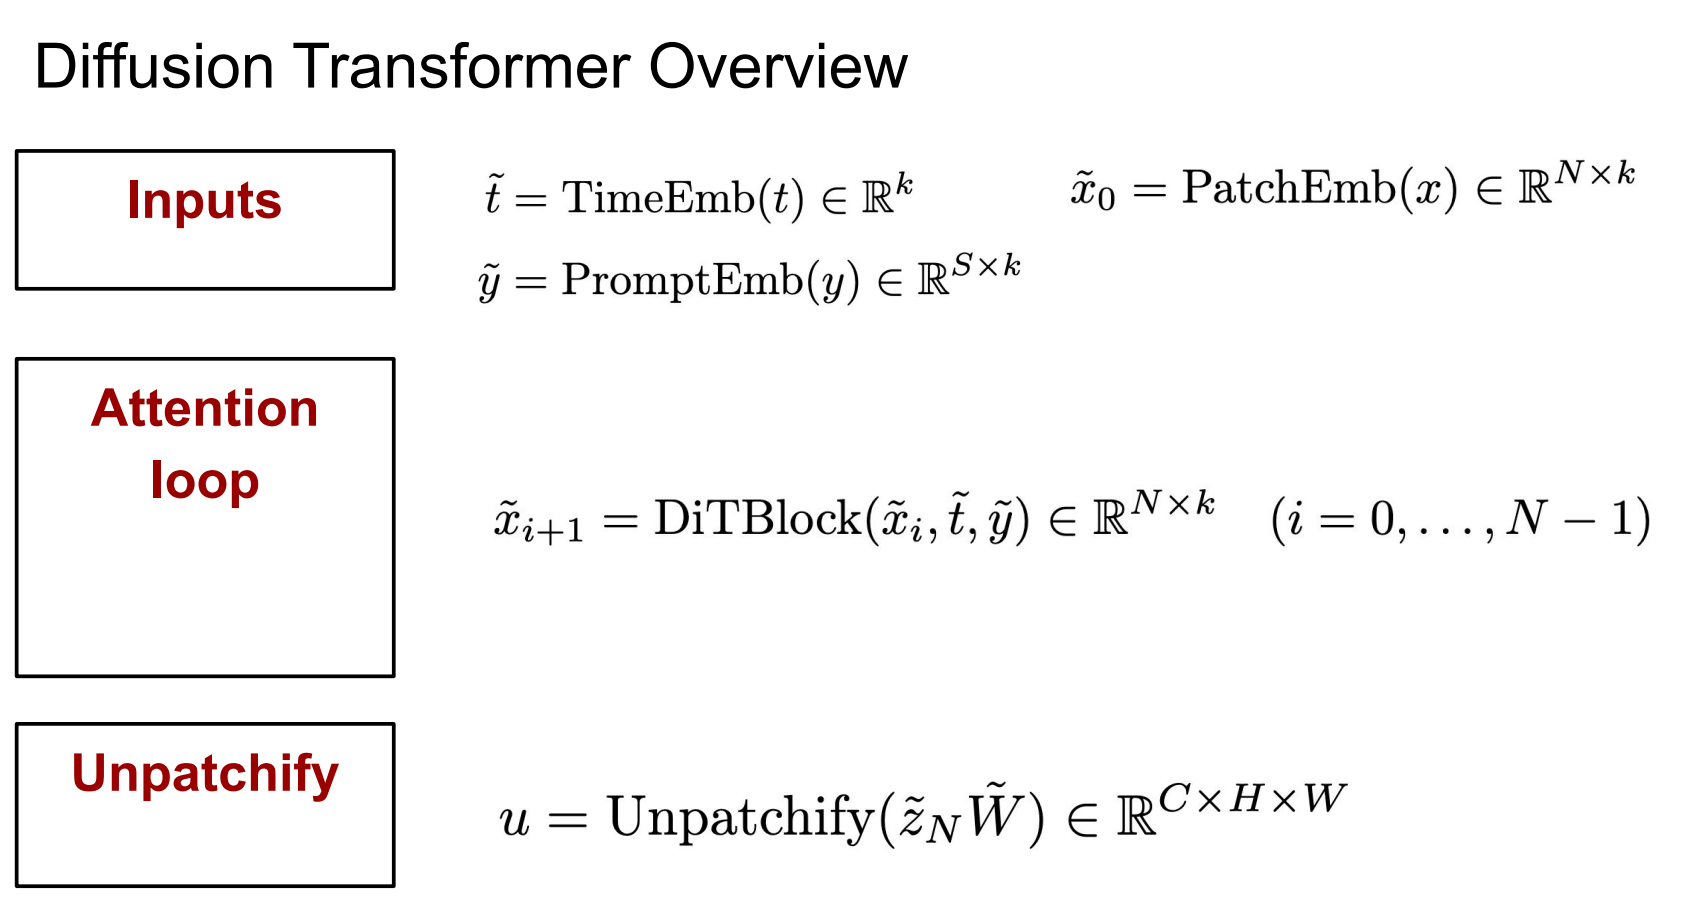
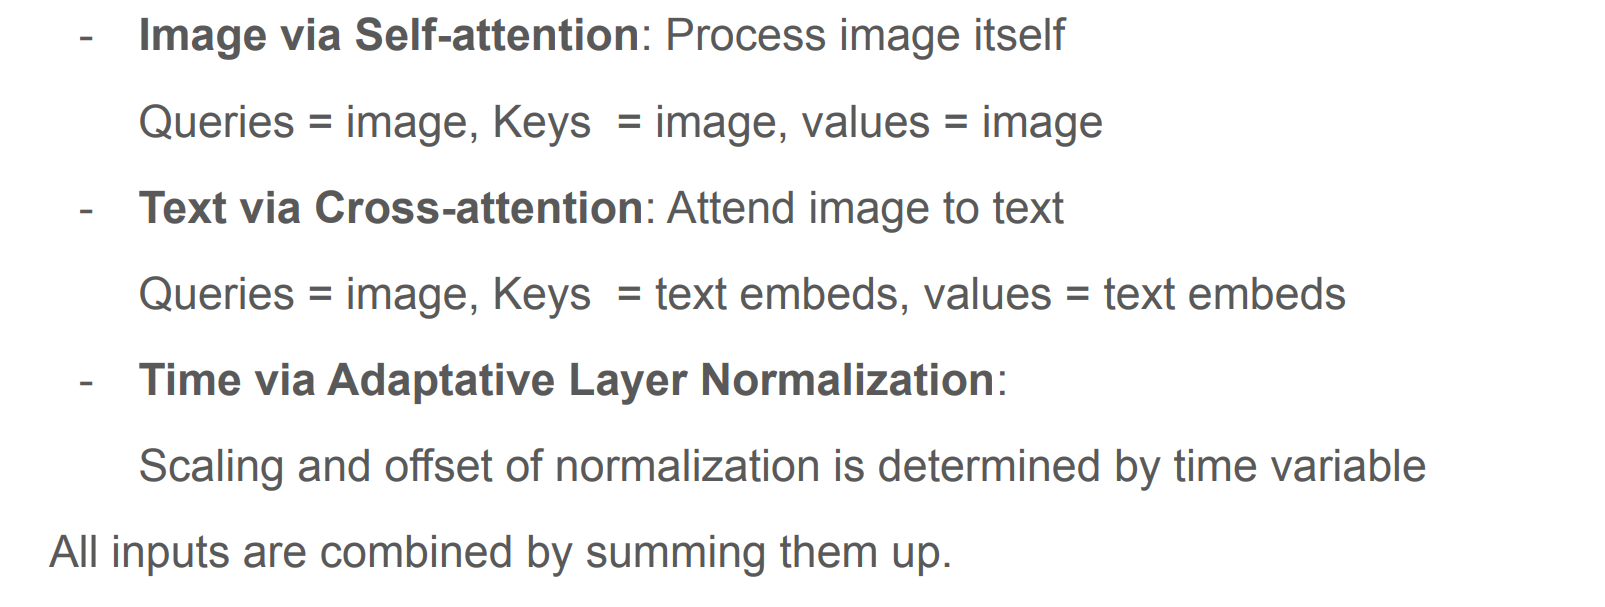
我们学习的目标如下,具有四个需要考虑的项。
\[\begin{align} u_{\textcolor{red}{t}}^{\textcolor{red}{\theta}} ( \underset{\underset{\text{Latent feature}}{\uparrow}}{\textcolor{red}{x}} \mid \underset{\underset{\text{Prompt Guidence}}{\uparrow}}{\textcolor{red}{y}} ) \end{align}\]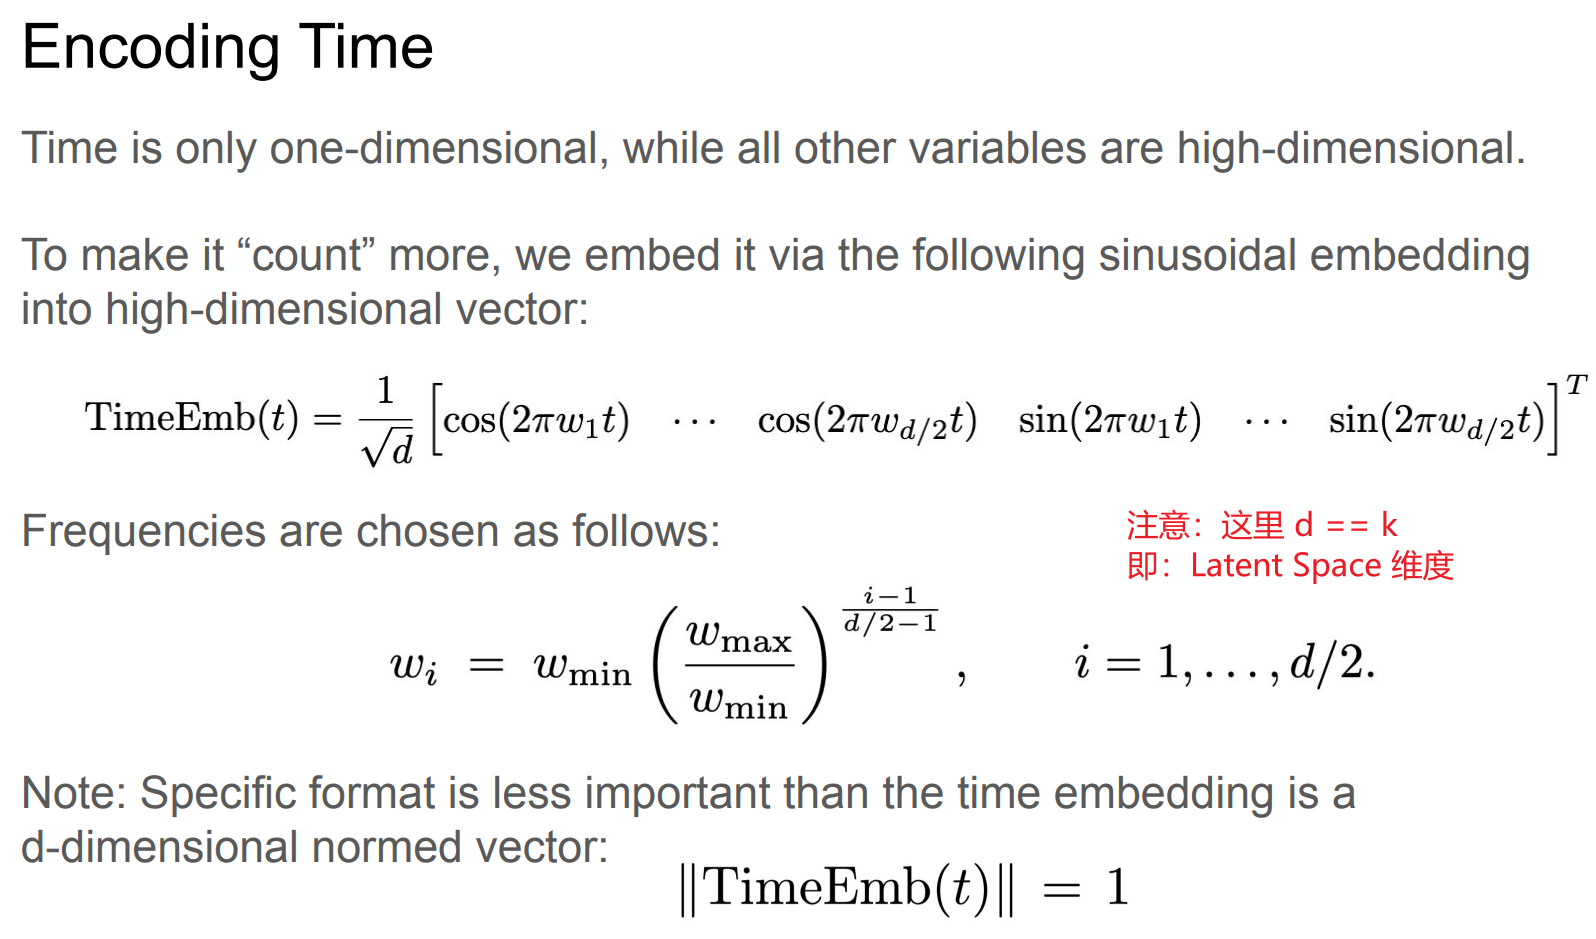
Diffusion Transformer
Lecture 6
走到这里,我们现在关注的重点变到:Dsecrete Diffusion Models。可惜的是在离散空间中,例如: Token Space; 没有 ODE/SDE, 也没有 flow/diffusion 等概念,因此我们无法通过前面 blog 内容一样进行 flow/diffusion models 的建模。幸运的是,我们可以借助 Continuous-time Markov chains (CTMCs) 这一数学工具来建模。
CTMC Models
首先定义:
- Vocabulary (词汇表): $\mathcal{V}={v_1, \dots, v_V}$. 其含义可以理解为:LLM 中的词汇表、英语中的字母表甚至在 Alpha-Fold 蛋白质生成中的 “原材料”——氨基酸的集合;
- State Space: $S=\mathcal{V}^d$;
- Rate Maritx: $Q: S\times S\times [0,1]\to \mathbb{R}_{\geq0}, (x,y,t)\mapsto Q_t(y\mid x)$; 其含义可以理解为:给定状态 $x,y,t$, $Q_t(y\mid x)$ 表示从 $x\to y$ 状态转变的 “速率”. $Q$ 需要满足:
- $Q_t(x\mid x)=-\sum_{y\neq x} Q_t(y\mid x)$. 理解为:不转变的 “速率” 和所有可能的转变的 “速率” 平衡。
接下来就可以定义 CTMC 了。
定义 $X_t \in S$ 是个随机变量. 定义转移概率 (Transition Prob): $p_{t+h\mid t}(X_{t+h}=y\mid X_t=x)$。有:
\[\begin{align} \frac{d}{dh\mid h=0} p_{t+h\mid t}(X_{t+h}=y\mid X_t=x) = Q_t(y\mid x) \end{align}\]其物理含义是:转移概率对时间间距 $h$ 的导数等于其 “速率”,由 $Q$ 给出。
Factorization Condition&CTMC Models
紧接着,我们定义 CTMC Model: $Q_t^\theta(z\mid x)$. 这里和前文 flow/diffusion model 思想类似,就是用一个神经网络来学习 Rate Matrix $Q$.
这里我们引入约束条件 Factorization condition: $Q_t^\theta(z\mid x)=0$ where $z_i\neq x_i$ for more than one $i$. 这个条件的含义就是约束转移前后的状态 (理解为两条向量的比较) 仅有一个索引处的取值是不同的。如下图所示,邻居 (neighbor) 的意思就是仅有一个索引处的取值不同, 存在差距且差距最小。
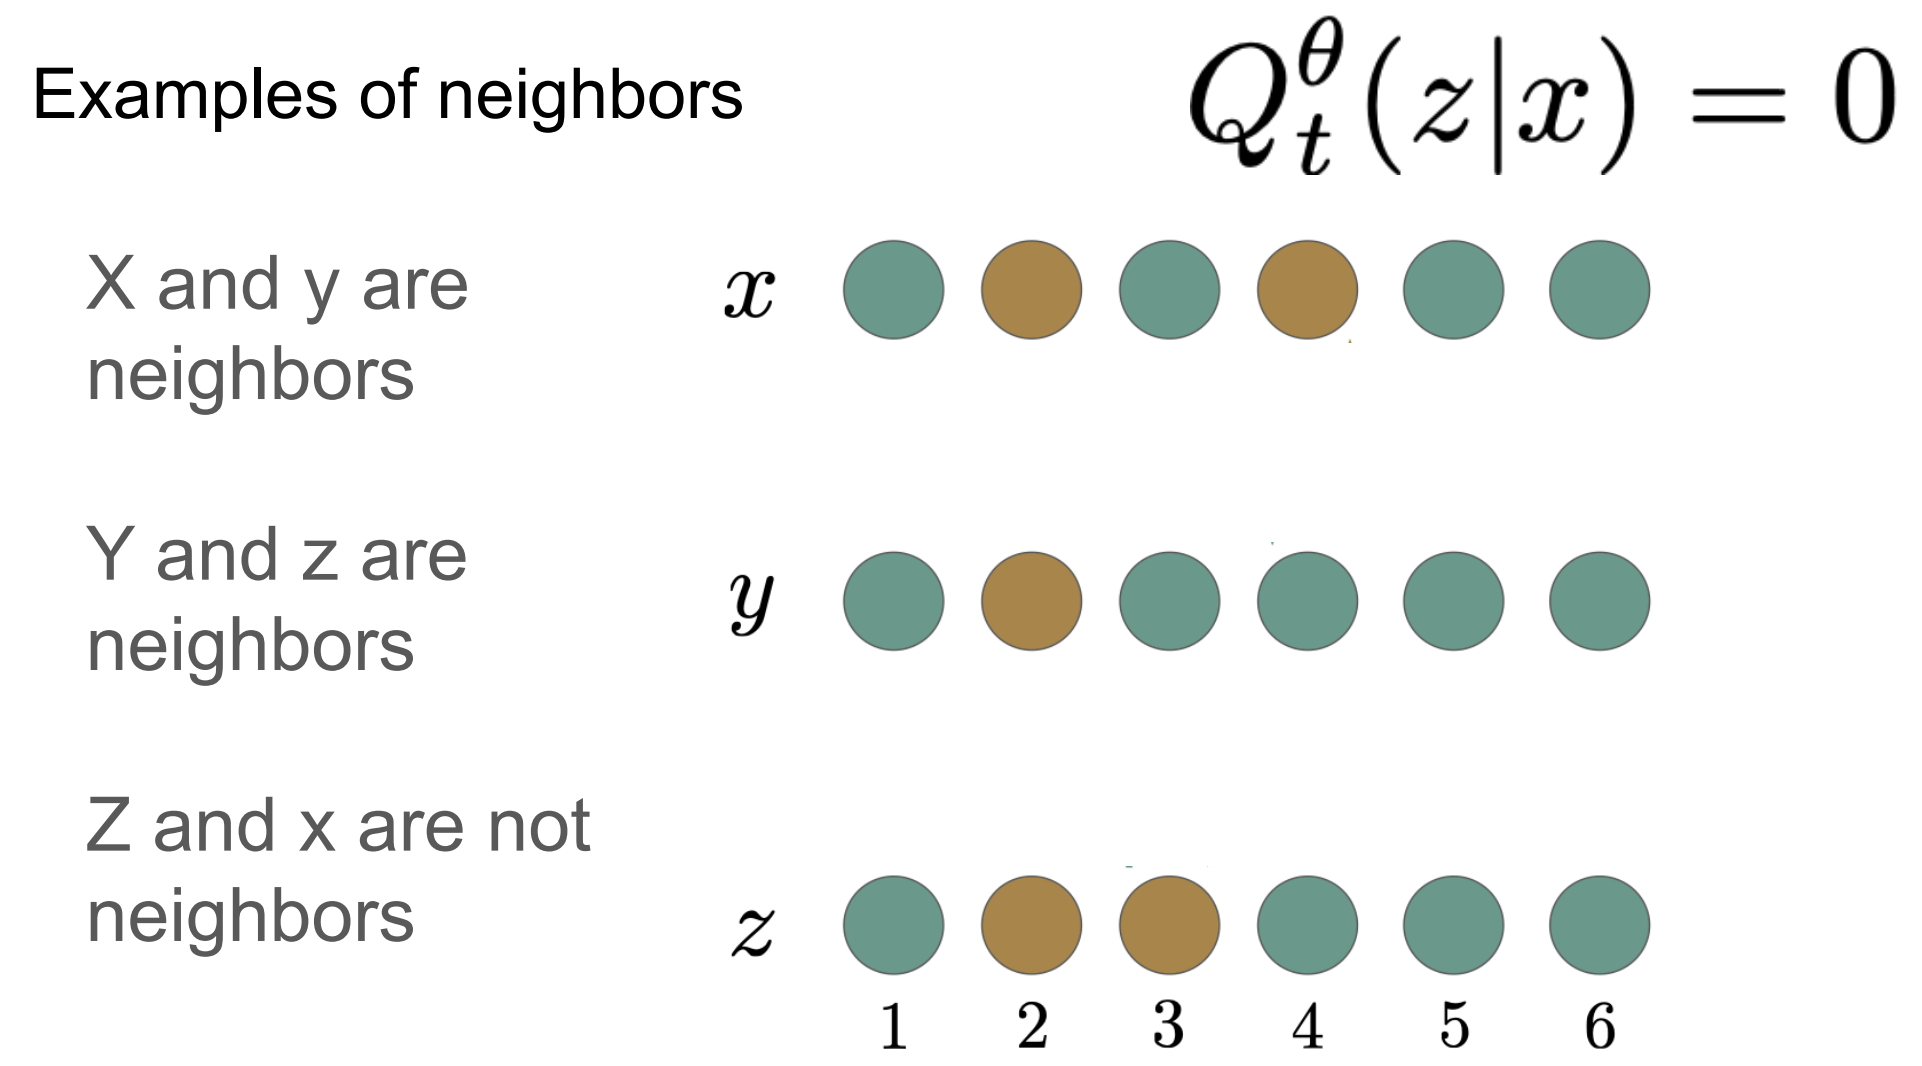
引入 Factorization condition 是为了降低 State Space 的规模,将其从 $V^d$ 减小为 $d\times V$.
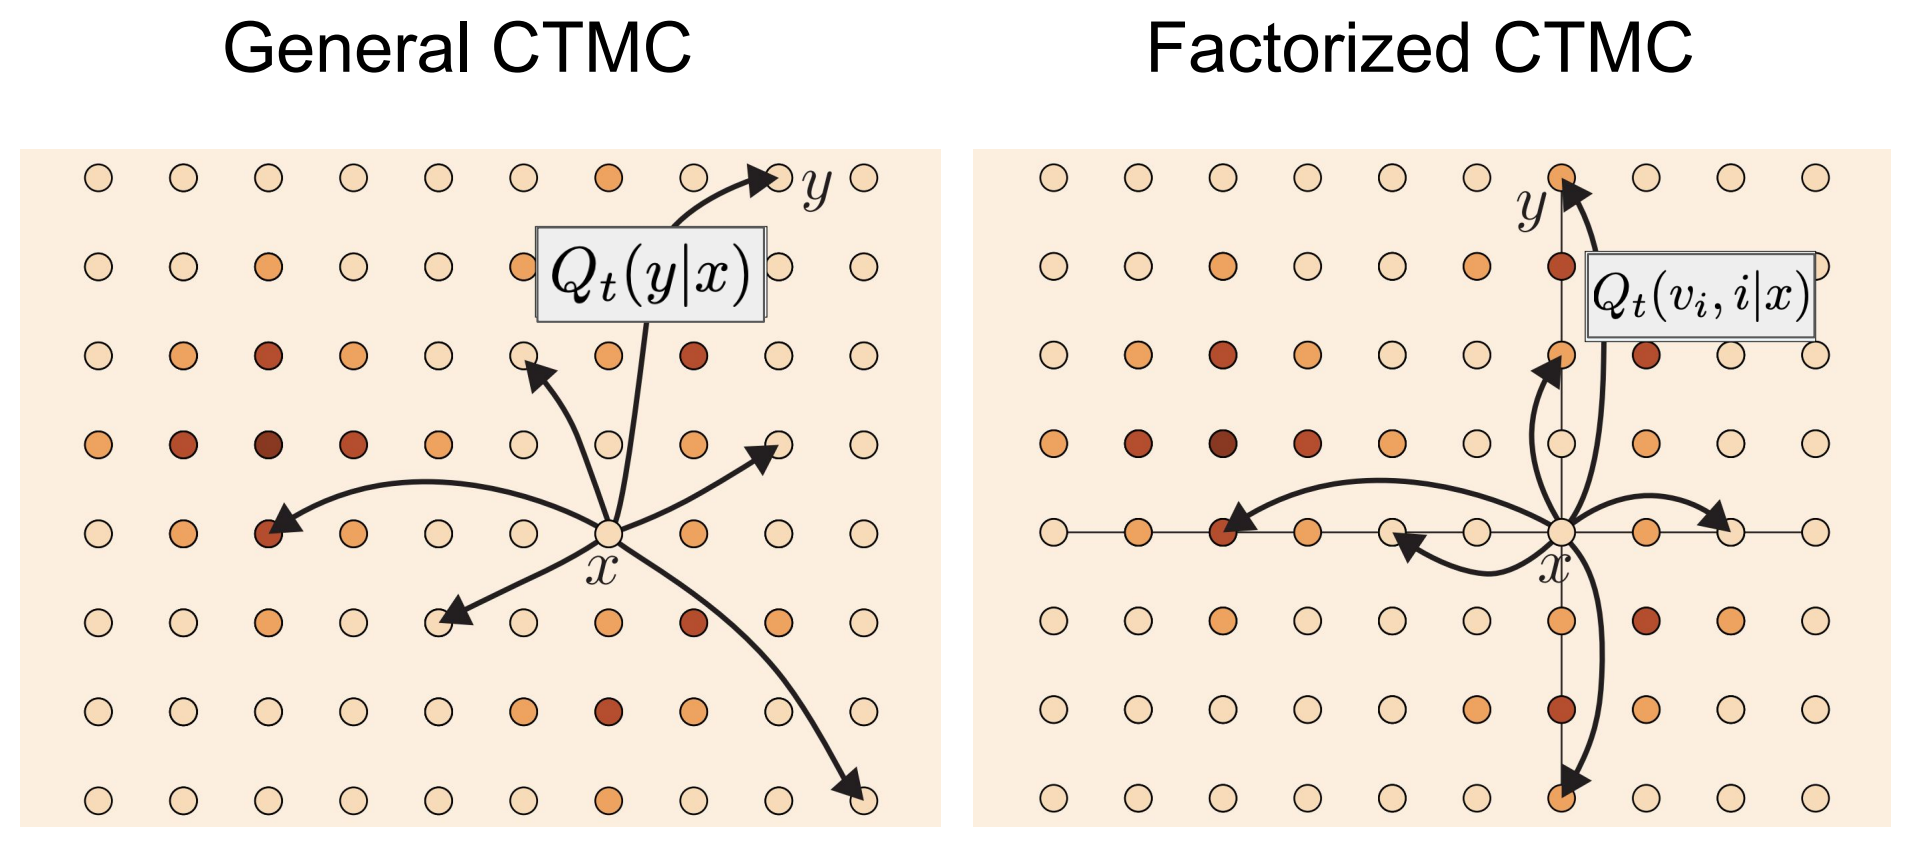
因此我们可以将转移后的 state $y$ 分解为: 该 state 哪个位置发生变化,以及发生了什么变化。也就构成了下式所示的 $v_i, j$:
\[\begin{align} (x,t)\mapsto \begin{pmatrix} Q_t^\theta(v_1, 1\mid x) & \dots & Q_t^\theta(v_V, 1\mid x) \\ \vdots & \vdots & \vdots \\ Q_t^\theta(v_1, d\mid x) & \dots & Q_t^\theta(v_V, d\mid x) \end{pmatrix}_{d\times V} = \left(Q_t^\theta(v_i, j\mid x) \right)_{i\in V, j\in[1,d]} \end{align}\]这个约束固然减少了转移的可能性;但是我们可以通过多步转移来达到没有 Factorization condition 时一步转移的效果。
Sampling with CTMC Models
尽管 Guassian Distribution 有很多良好性质,也是我们前文中经常用来建模的对象。但是在离散情况下,Gaussian Distribution 不存在。因此我们选用 $p_{\text{init}}=\mathbf{Unif}_S$. 此外在离散情况下,Delta function: $\delta_y(x)=\begin{cases}1,\qquad y=x \ 0,\qquad y\neq x \end{cases}$.
\[\begin{align} X_0\sim p_{\text{init}}, \qquad X_{t+h}\sim &p_{t+h\mid t}(y\mid X_t) \\ =& p_{t\mid t}(y\mid X_t) + h\cdot \frac{d \left(p_{t+h\mid t}(y\mid X_t) \right)}{dh\mid h=0} ——\text{在 h=0 处利用 Taylor Expansion } \\ =& \delta_y(X_t) + h\cdot Q_t^\theta(y\mid X_t) ——\text{利用 $\delta$ 和 Rate Matrix 的定义} \end{align}\]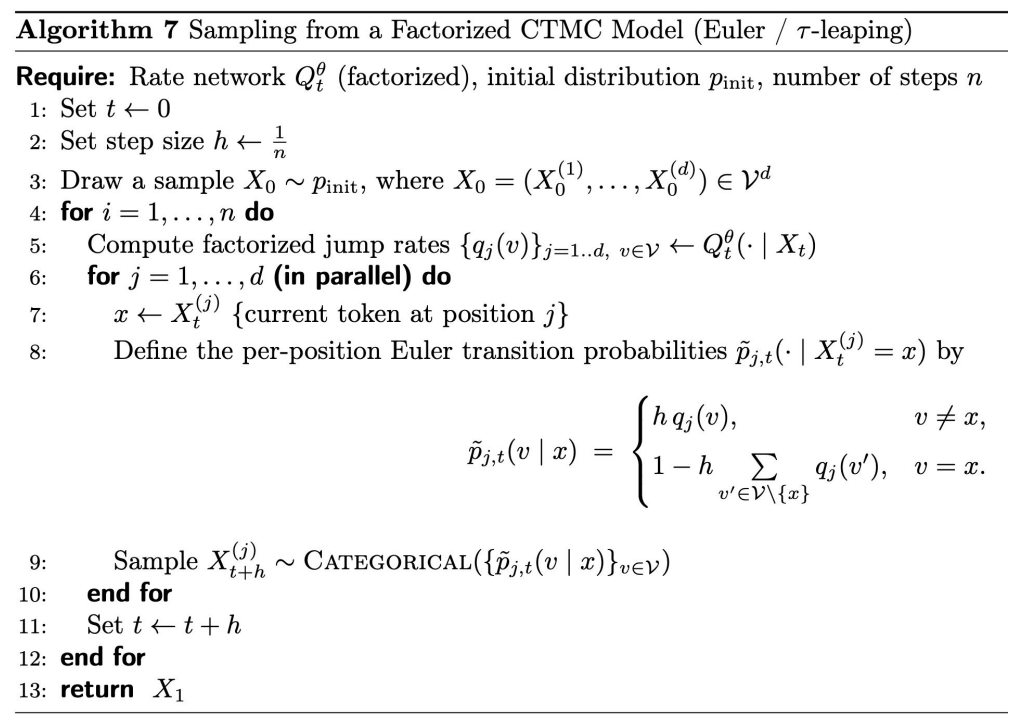
Discrete Flow Matching
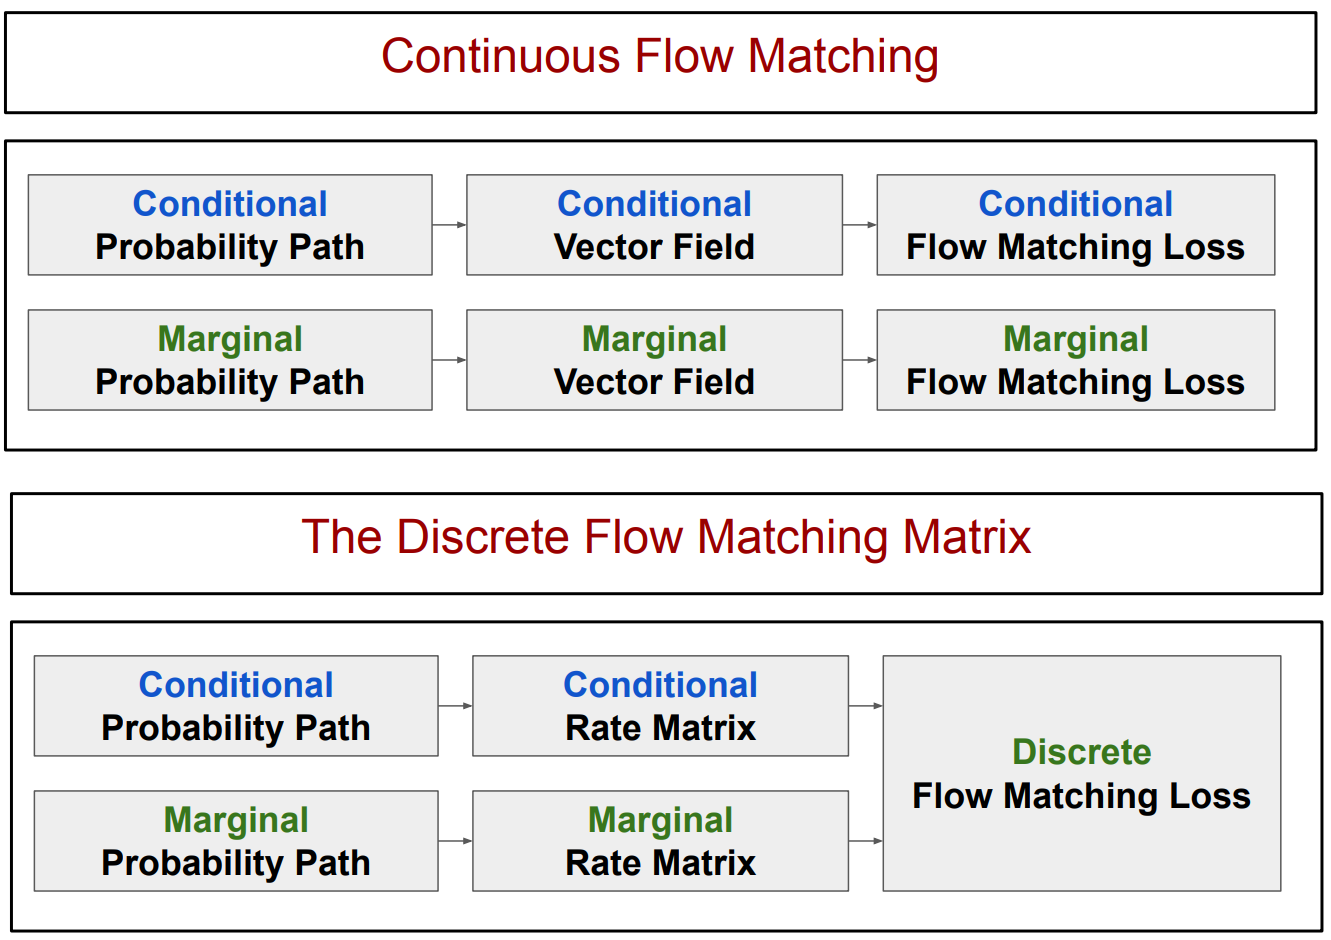
Probability Path
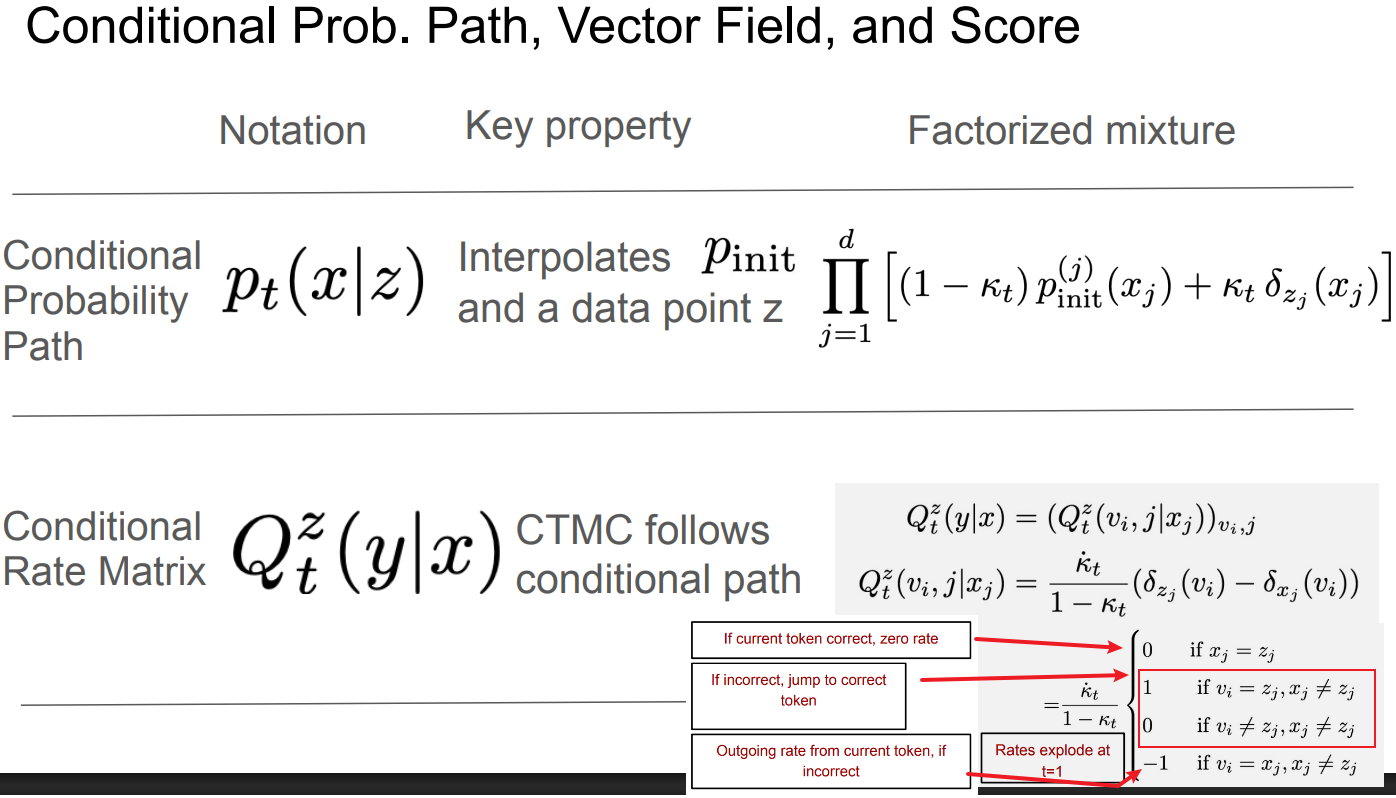
Conditional Prob Path: $p_t(x\mid z)$; 满足 $p_0(x\mid z)=p_{\text{init}}, p_1(x\mid z)=\delta_z(x)$;
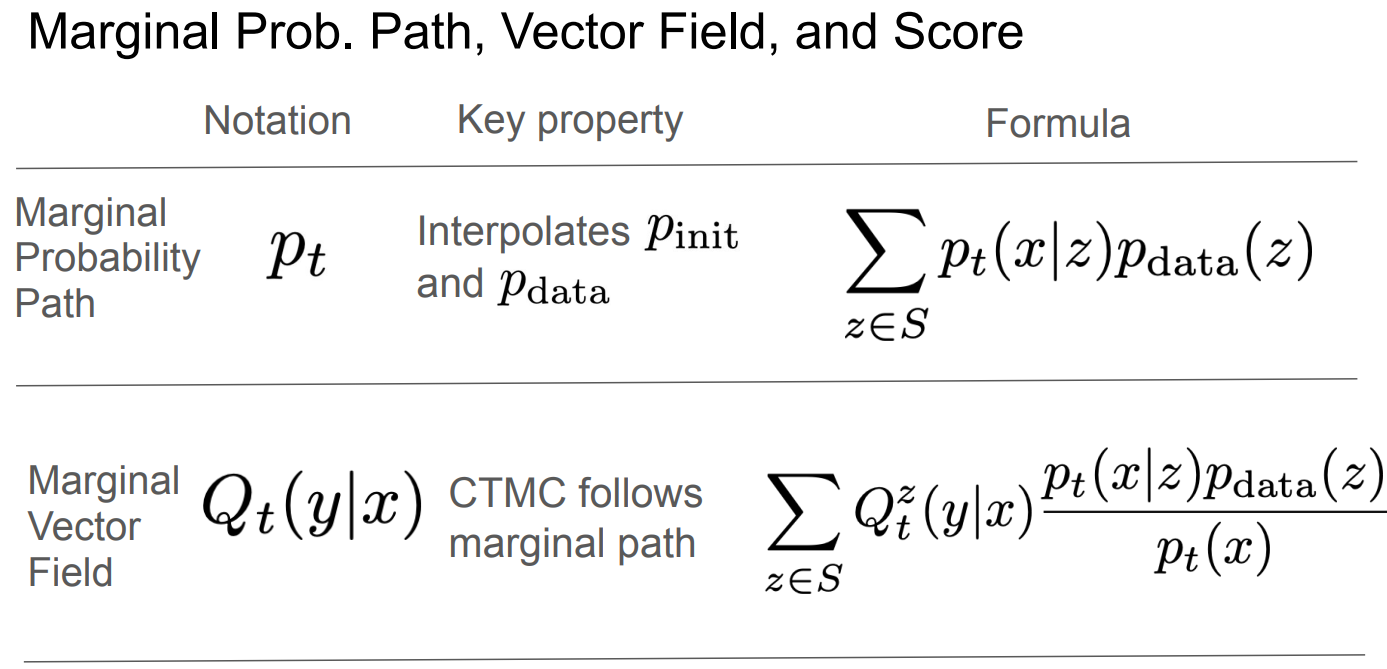
Marginal Prob Path: $p_t(x) = \sum_{z\in S} p_t(x\mid z) p_{\text{data}}(z)$; 满足 $p_0(x)=p_{\text{init}}, p_1(x)=p_{\text{data}}$.
Rate Matrix
Conditional Rate Matrix: $Q_t^\textcolor{red}{z}(y\mid x)$, where $x,y,z\in S$. 这里是针对单个点 $z$ 的。有下述蕴含式成立:
\[\begin{align} X_0\sim p_{\text{init}},X_t \text{ CTMC of } Q_t^z \implies X_t\sim p_t(\cdot\mid z). \end{align}\]Marginal Rate Matrix:
\[\begin{align} Q_t(y\mid x) = \sum_{z\in S} Q_t^z(y\mid x)\cdot \frac{p_t(x\mid z) p_{\text{data}}(z)}{p_t(x)} \end{align}\]Discrete Marginalization Trick:
\[\begin{align} X_0\sim p_{\text{init}},X_t \text{ CTMC of } Q_t \implies X_t\sim p_{t}\implies X_1\sim p_{\text{data}}. \end{align}\]Proof. 已知下述定理:
\[\begin{align} X_t\sim p_t \iff \underbrace{\frac{d}{dt} p_t(x)=\sum_{y\in S} Q_t(x\mid y)p_t(y)}_{\text{Kolmogorov Forward Equation (KFE)}}. \end{align}\]KFE 物理含义: 乍一看,KFE 等式右边仅有 $y\to x$ 的项,以 $x$ 为中心观察,仅有 “流入”,没有 “流出”。这和前文的 Continuous Equation 的物理含义并不一致。但实际上,我们只要稍加转换,就能发现 KFE 和 Continuous Equation 一样是 “流入-流出”。
\[\begin{align} \sum_{y\in S} Q_t(x\mid y)p_t(y) &= \sum_{y\neq x} Q_t(x\mid y)p_t(y) + \underbrace{Q_t(x\mid x)p_t(x)}_{x=y} \\ &= \underbrace{\sum_{y\neq x} Q_t(x\mid y)p_t(y)}_{\text{流入 $x$}} + \left(- \underbrace{\sum_{y\neq x} Q_t(y\mid x)p_t(x)}_{\text{流出 $x$}} \right) \end{align}\]因此若想证明 Discrete Marginalization Trick 成立,则需要证明 KFE holds.
\[\begin{align} \frac{d}{dt} p_t(x) &= \frac{d}{dt} \sum_{z\in S} p_t(x\mid z) p_{\text{data}}(z) \\ &= \sum_{z\in S} \frac{d}{dt} p_t(x\mid z) p_{\text{data}}(z) \\ &= \sum_{z\in S} \left(\sum_{y\in S} \underbrace{Q_t(x\mid y, z)}_{\text{i.e, }Q_t^t(x\mid y)} p_t(y\mid z) \right)p_{\text{data}}(z)——\text{默认 conditional path $p_t(x\mid z)$ 遵守 KFE.} \\ &= \sum_{y\in S} \sum_{z\in S} Q_t^z(x\mid y)p_t(y\mid z) p_{\text{data}}(z) \\ &= \sum_{y\in S} \left[\sum_{z\in S} Q_t^z(x\mid y)\frac{p_t(y\mid z) p_{\text{data}}(z)}{p_t(y)} \right] p_t(y) \\ &=\sum_{y\in S} Q_t(x\mid y)p_t(y)——\text{利用 marginal rate matrix $Q_t(x\mid y)$ 定义.} \end{align}\]因此有,Marginal Prob Path 遵守 KFE。根据定理可得 $X_t\sim p_t$.
现在我们可以总结如下:
Training
根据上述 Marginal Rate Matrix 的式子, 我们要想训练一个 Marginal Rate Matrix $\iff$ 训练一个分类器。
\[\begin{align} Q_t(v_i, j\mid x) = \frac{\dot{\kappa_t}}{1 - \kappa_t}(p_{1\mid t}(z_j = v_i\mid x) - \delta_{x_j}(v_i)). \end{align}\]因此接下来我们的目标就是训练一个后验分类器,虽然称下述损失为 Discrete Flow Matching Loss $\mathcal{L}_{DFM}$, 但是其实本质就是训练分类器常见的 cross-entropy loss:
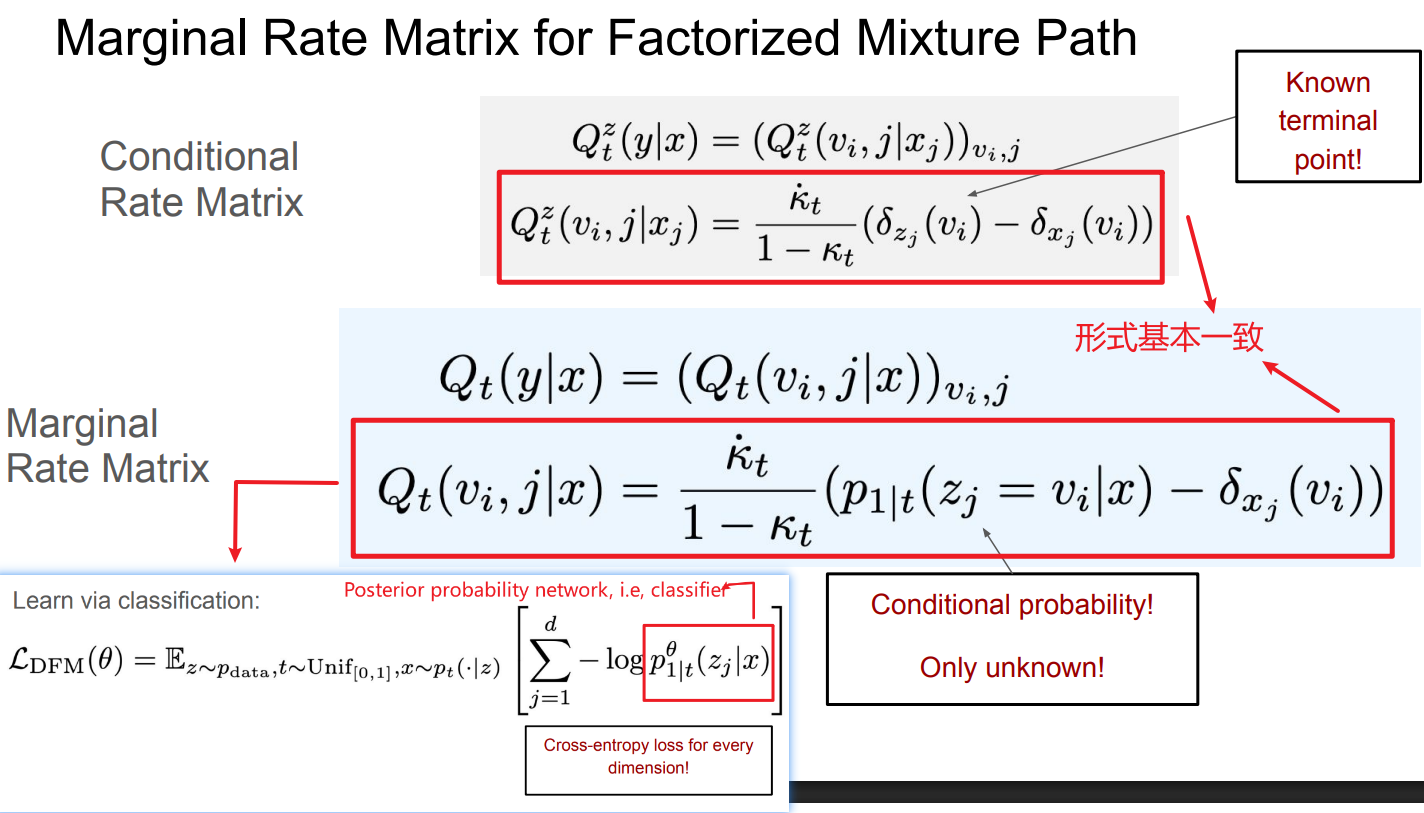
训练完之后再进行针对 CTMC Models 的采样,就是所谓的 Discrete Flow Matching 了!
The End
MIT 6.S184 课程完结撒花~后续随缘更新相关的论文解读。