前言
笔者近期学习了 MIT 的 6.S184 课程,将笔记整理于此。便于复习,也希望能够帮助到感兴趣的读者。
Lecture 3
Score
将前文中的 Probability Path 进行拓展,得到对应的 score:
-
Conditional Score: $\nabla_x \log p_t(x\mid z)$;
-
Marginal Score: $\nabla_x \log p_t(x)$.
这里是将原来对应的 Prob Path 进行 $\text{log-likelihood}$ 之后再取 $\text{gradient}$。
二者之间存在关系:
\[\begin{align} \nabla_x \log p_t(x) = \int \nabla_x \log p_t(x\mid z) \frac{p(z\mid x)p_{\text{data}}(z)}{p_t(x)}dz. \end{align}\]Proof. \(\begin{align} \nabla_x \log p_t(x) &= \frac{\nabla_x p_t(x)}{p_t(x)} \\ &= \frac{\nabla_x}{p_t(x)} \int \log p_t(x\mid z)\cdot p_t(z\mid x) p_{\text{data}}(z) dz \\ &= \int \nabla_x \log p_t(x\mid z) \frac{p(z\mid x)p_{\text{data}}(z)}{p_t(x)}dz. \end{align}\)
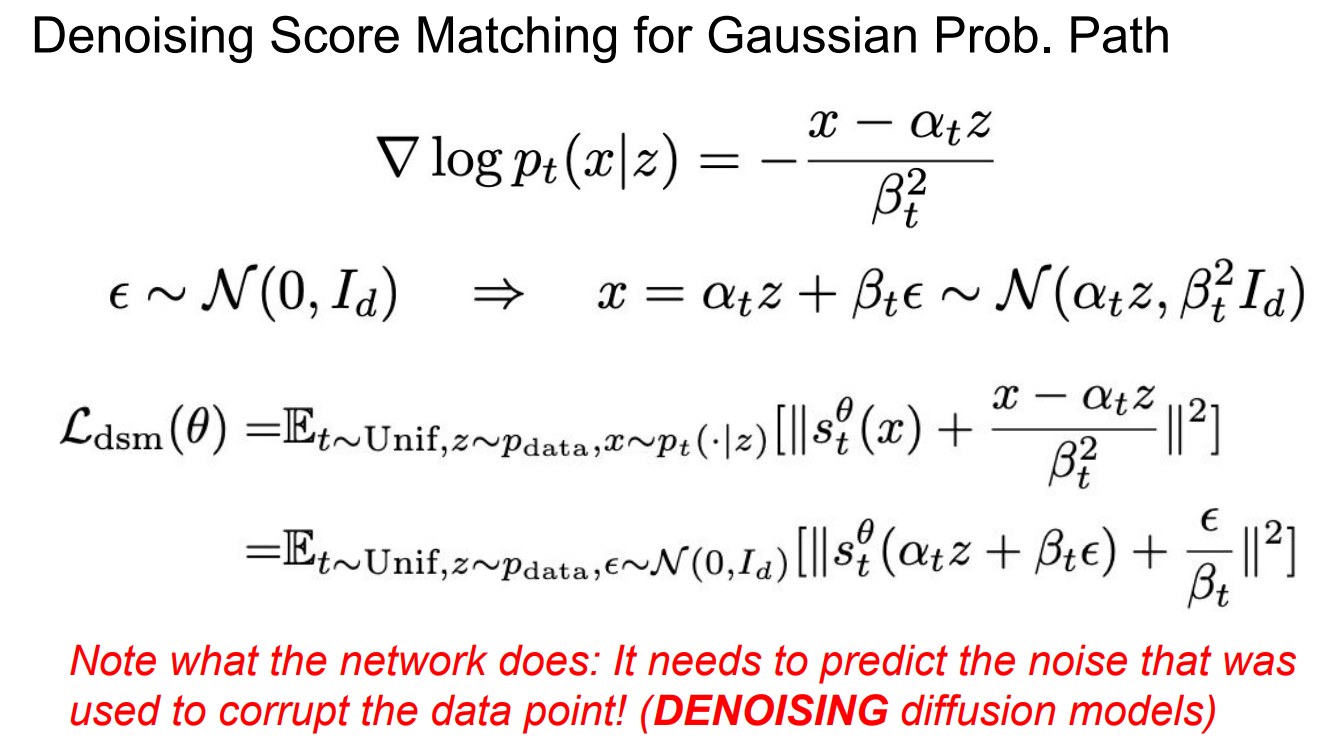
下面给出一个具体的 Conditional Score (based on Gaussian) 的计算方式:
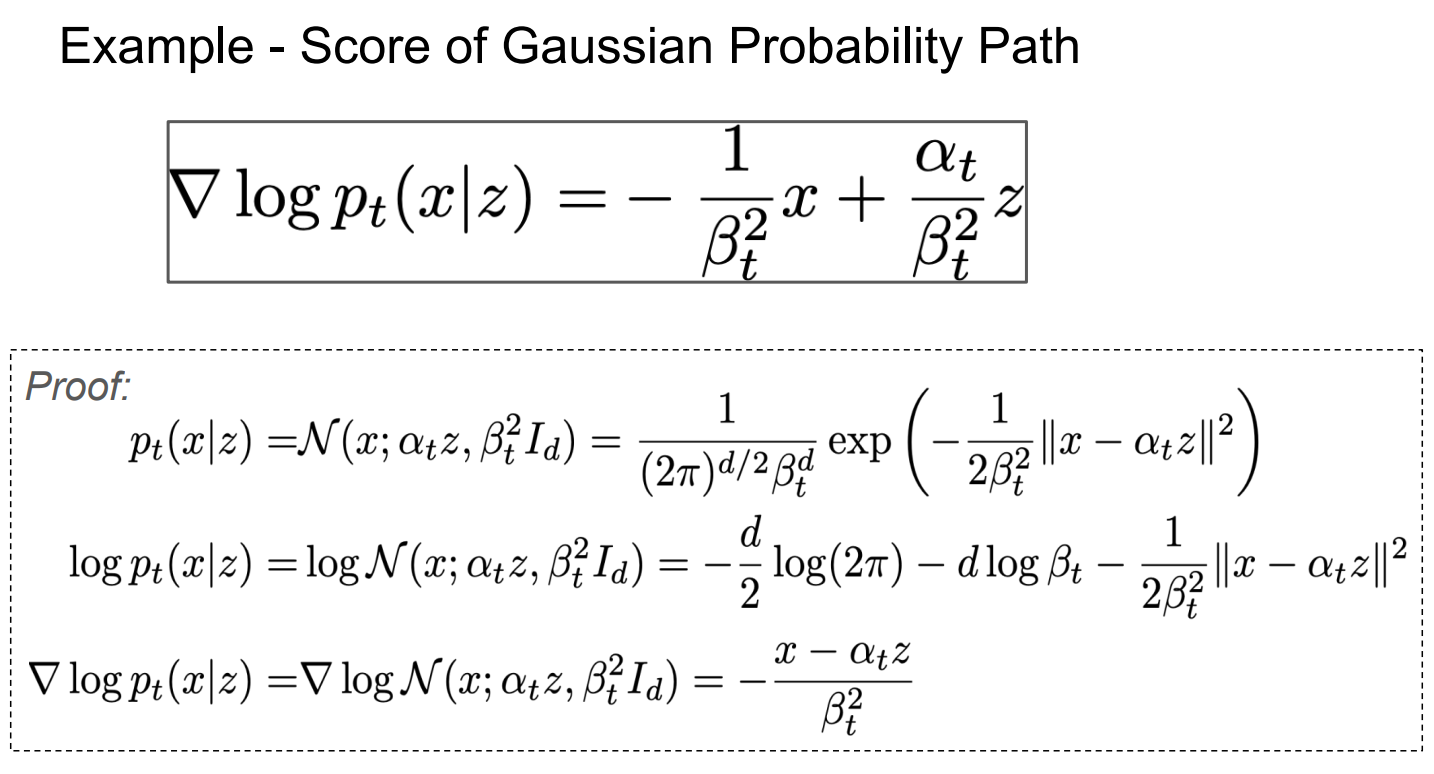
基于 Gaussian noise,则有如下代数等式成立:
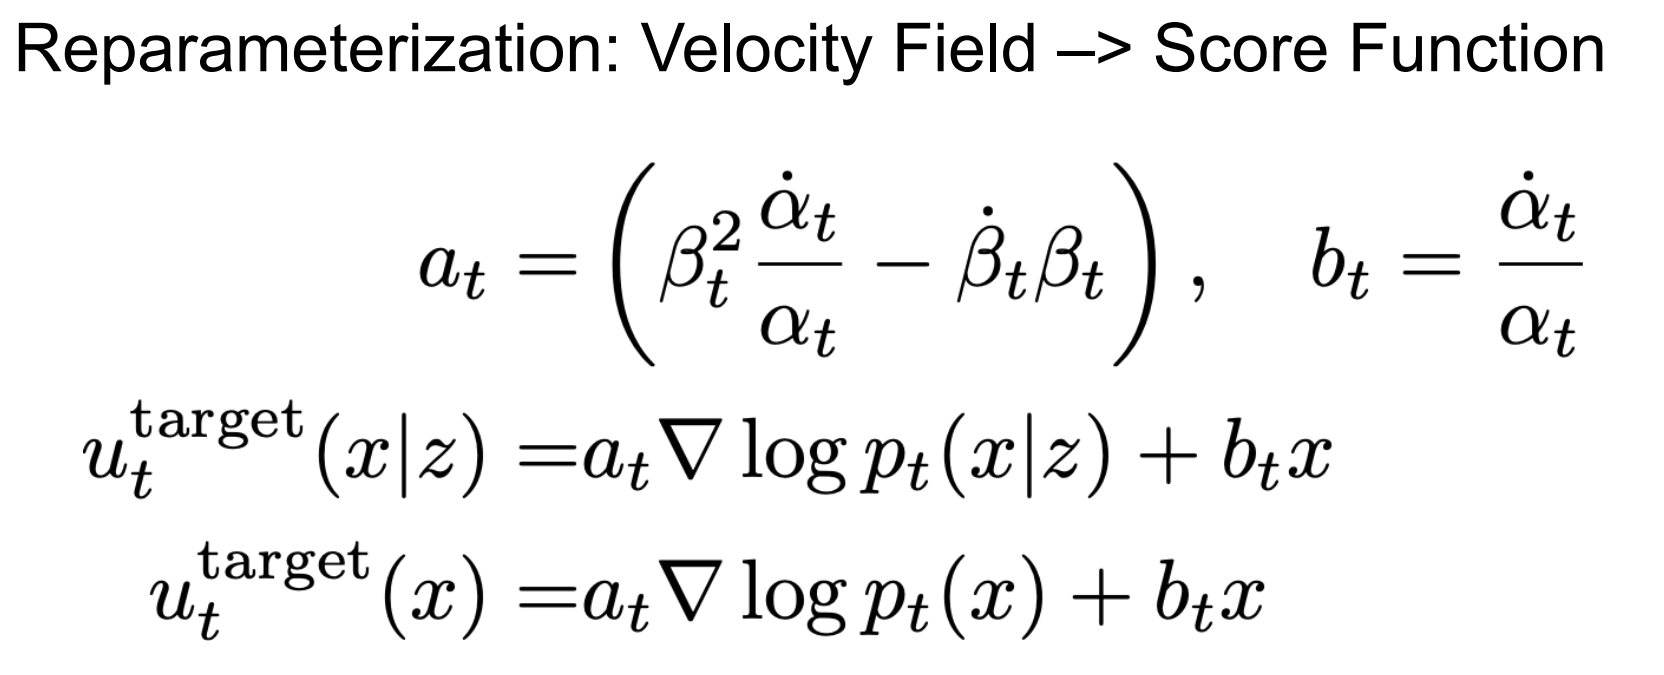
虽然上述关系式是特例,不适用于非高斯的生成模型或一般的前向过程,但是这种思想是通用的:Score Function 和 Vector Field 本质上是同一回事!
Score Matching
Score Matching Loss: \(\begin{align} \mathcal{L}_{SM}(\theta)=\mathbb{E}_{t,x}\left[\|s_t^\theta(x) - \log p_t(x) \|^2 \right] \end{align}\)
Denosing SM Loss:
\[\begin{align} \mathcal{L}_{DSM}(\theta)=\mathbb{E}_{t,z,x}\left[\|s_t^\theta(x) - \log p_t(x\mid z) \|^2 \right] \end{align}\]同理有:
\[\begin{align} \mathcal{L}_{SM}(\theta) = \mathcal{L}_{DSM}(\theta) + \text{Constant} \end{align}\]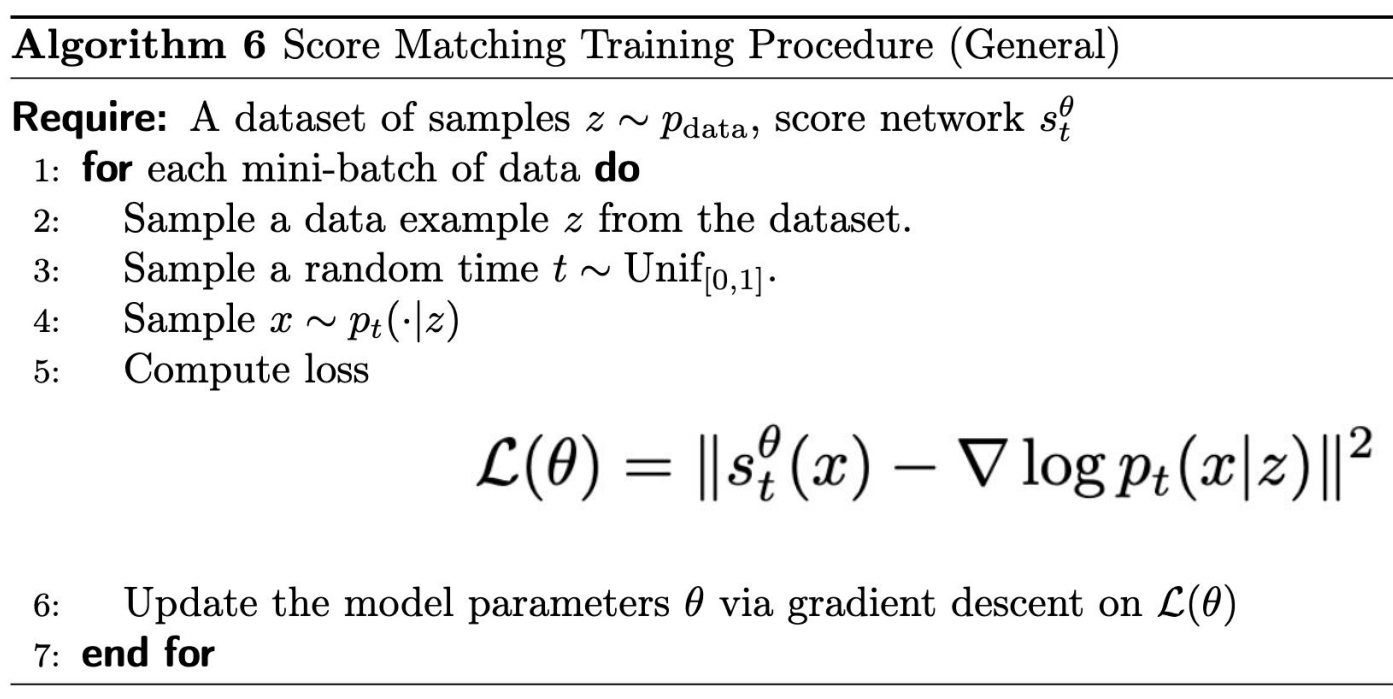
SDE Extention of Marginal Trick
这里回顾一下 Marginal Trick:
\[\begin{align} X_0\sim p_{\text{init}}, dX_t=u_t^\text{target}(X_t)dt\implies X_t\sim p_t. \label{eq:marginalization_trick} \end{align}\]我们想在上述 ODE 中引入 “随机性”,也就是将 ODE 转换为 SDE. \(\begin{align} X_0\sim p_{\text{init}}, dX_t=\left[u_t^\text{target}(X_t) + \frac{\sigma_t^2}{2}\nabla_x \log p_t(X_t)\right]dt + \sigma_t dW_t \implies X_t\sim p_t. \label{eq:sde_extention} \end{align}\)
其中 $\sigma_t\in \mathbb{R}_{\geq 0}$ 控制随机性的强度。 这允许我们得到一系列模型,虽然它们在理论上做了一样的事情 $X_t\sim p_t$,不具有区分度;但是我们可以通过 Empirical 来实测进行 model selection.
Proof.
需要借助下述定理:
\[\begin{align} X_t\sim p_t \iff \frac{d}{dt} p_t(x) = \underbrace{-\textbf{div} (p_tu_t)(x) + \underbrace{\frac{\sigma_t^2}{2} \Delta p_t(x)}_{\text{Heat Disperision}}}_{\text{Fokker-Planck Equation}} \end{align}\]如何理解 Fokker-Planck Equation 方程呢?其中 $\textbf{div}(\cdot)$ 和此前的 Continuity Equation 中的项的物理含义一致, 表示 “流入-留出” 量; $\text{Heat Dispersion Term}$ 理解为 “热辐射”, 即不仅有 vector field 的影响, 物质本身也在不断地消耗自身能量, 这里对相较于 Continuity Equation,对该现象作出了修正。这里的 $\Delta p_t(x) \triangleq \textbf{div}(\nabla p_t(x))(x) = \sum_{i=1}^{d} \frac{\partial^2}{\partial^2 x_i^2}w_t(x)$.
借助定理,若要证明 Eq. ($\ref{eq:sde_extention}$),则只需要证明将 ODE 转化为 SDE 后的 $p_t(x)$ 满足 Fokker-Planck Equation。
\[\begin{align} \frac{d}{dt} p_t(X_t) &= -\textbf{div} (p_t(X_t) u_t^\text{target}(X_t))(x)——\text{由 Continuity Equation 保证} \\ &= -\textbf{div} (p_t(X_t) u_t^\text{target}(X_t))(x) \underbrace{-\textbf{div} (\frac{\sigma_t^2}{2}\nabla p_t(X_t))(x) + \frac{\sigma_t^2}{2} \Delta p_t(x)}_{=0}——\text{由 $\Delta$ 定义保证} \\ &= -\textbf{div} \left[p_t(X_t) u_t^\text{target}(X_t) + \frac{\sigma_t^2}{2}\nabla p_t(X_t) \right](x) + \frac{\sigma_t^2}{2} \Delta p_t(x)——\text{由 $\textbf{div}$ 线性保证} \\ &= -\textbf{div} \left[p_t(X_t) u_t^\text{target}(X_t) + \frac{\sigma_t^2}{2} \left(p_t(X_t)\cdot \nabla\log p_t(X_t)\right) \right](x) + \frac{\sigma_t^2}{2} \Delta p_t(x) \\ &= -\textbf{div} \left[p_t(X_t) \left(u_t^\text{target}(X_t) + \frac{\sigma_t^2}{2} \nabla\log p_t(X_t)\right) \right](x) + \frac{\sigma_t^2}{2} \Delta p_t(x) \end{align}\]综上,转化为 SDE 后的 $p_t(x)$ 确实满足 Fokker-Planck Equation,因此根据定理可知,一定有 $X_t\sim p_t$ 成立。
在 SDE 中加入“随机噪声项 $\sigma_t dW_t$,反映在概率密度的 FPE 演化方程中,就必然新增一个“扩散项 $\frac{1}{2}\sigma_t^2 \Delta p_t$. 不管 $p_t$ 是什么分布;但是需要保证 $\sigma_t$ 仅依赖于时间 $t$,与位置 $X_t$ 无关。
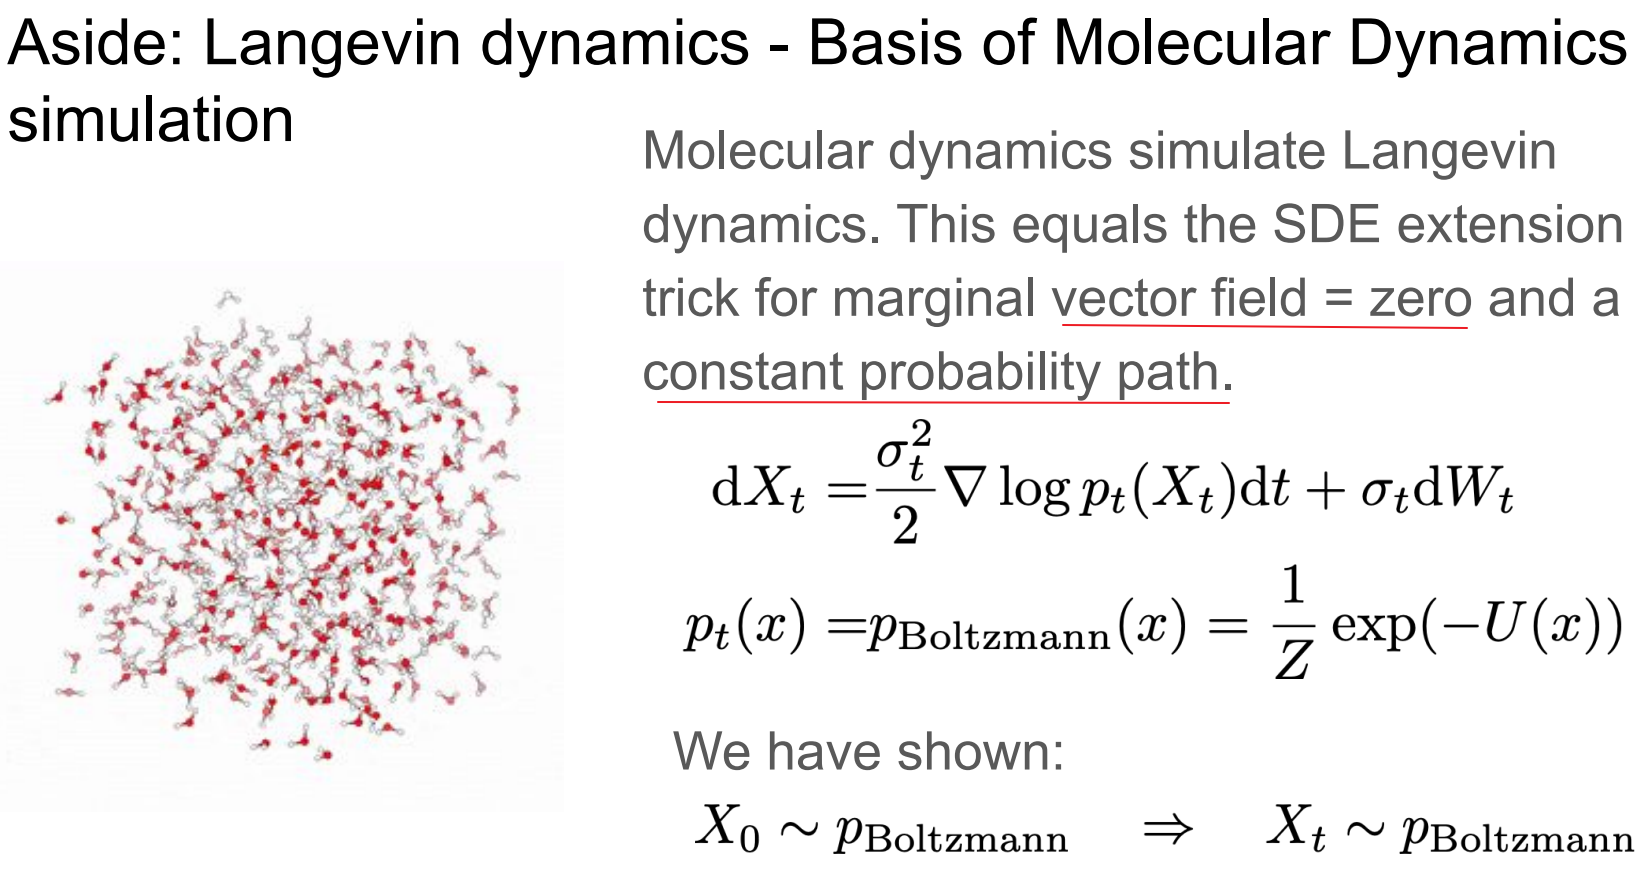
下面有个小拓展,Langevin Dynamic 其实和 SDE 存在下述关联。
Lecture 4
在实际场景中,我们还希望能够通过 prompt 来引导模型生成对应的内容(图像、视频等),我们将其称为 “Guidence”。
首先给出 notation:
Data distribution: $(z, y)$, where $y$ is prompt and $z\in \mathbb{R}^d$ is vector.
Guidence Vector Field: 将 $y$ 也作为模型的输入,形式化为:$u_t^\theta(x\mid y)\in \mathbb{R}^d$.
Guidence FM Loss:
\(\begin{align} \mathcal{L}_{CFM}(\theta) = \mathbb{E}_{t\in \text{Uni}[0,1], \textcolor{red}{(z,y)} \sim p_{\text{data}}(z\textcolor{red}{, y}), x\sim p_t(x\mid z)}\left[ \left\|u_t^{\theta}(x \textcolor{red}{\mid y}) - u_t^{\text{target}}(x\mid z) \right\|^2 \right] \end{align}\) 如上式所示,和 Unguidence FM Loss 相比有红色部分不同。
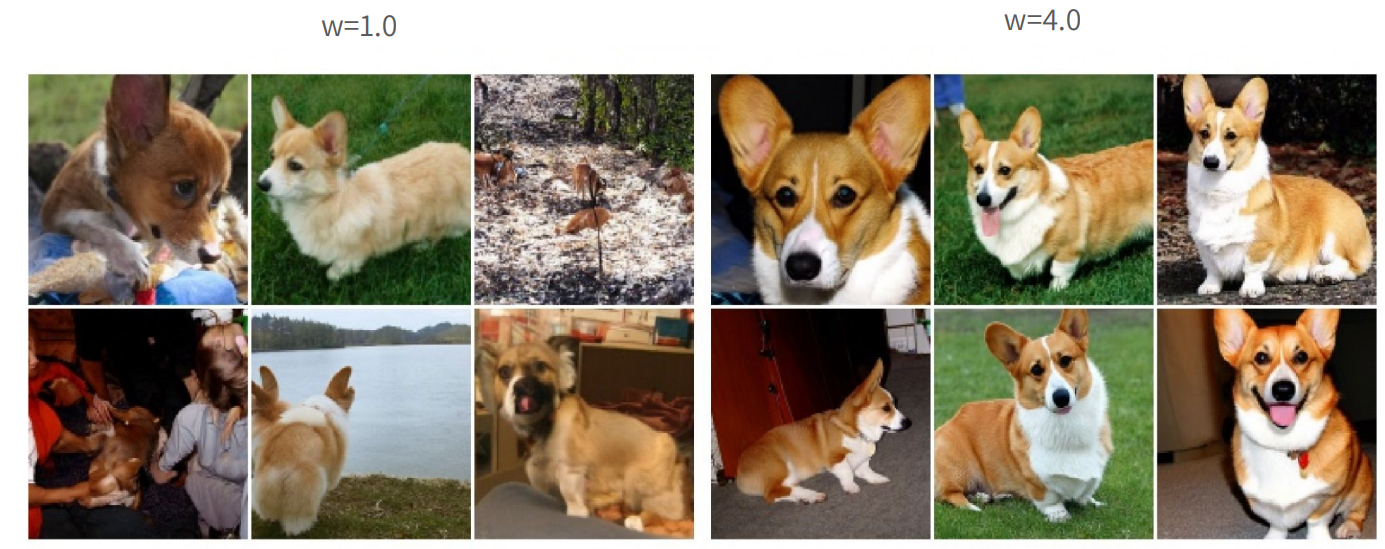
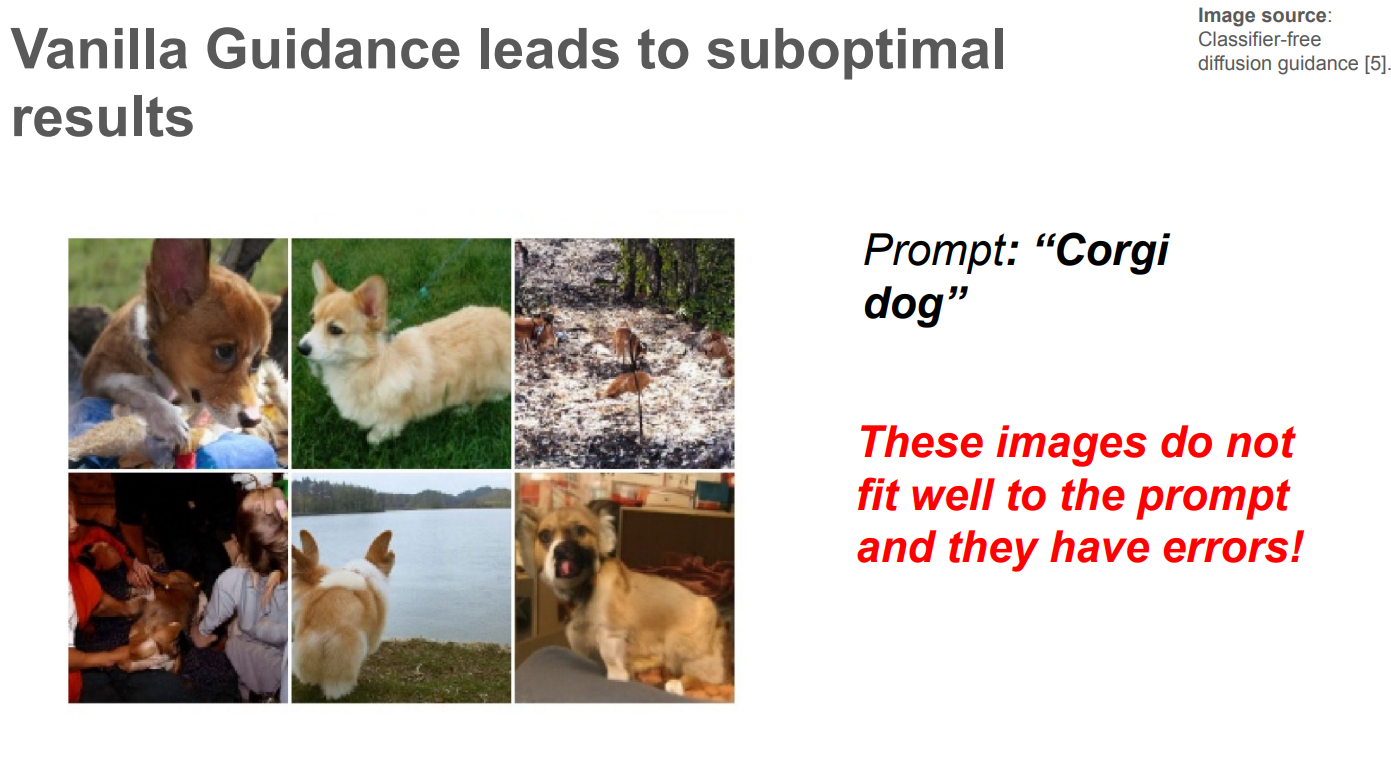
理论上,如此就实现了 “Guidence Generation”. 但是 $\textcolor{red}{(z,y)} \sim p_{\text{data}}$ 这里的 $y\sim \mathcal{Y}$ 表示简单粗暴地在语义相近的 prompt 集合中采样,实际的生成质量不佳,如下生成的柯基所示。
Classifier Guidence
基于贝叶斯定理,有:
\[\begin{align} p_t(x\mid y) = \frac{p_t(y\mid x) p_t(x)}{p_t(y)} \end{align}\]两边同时取 $\log$ 以及 $\nabla_x$ 之后得到:
\[\begin{align} \nabla_x \log p_t(x\mid y) = \nabla_x \log p_t(y\mid x) + \nabla_x \log p_t(x) -\underbrace{\xcancel{\nabla_x \log p_t(y)}}_{\text{因为关于 $x$ 梯度为 $0$}} \label{eq:guided_score_with_unguided_score} \end{align}\]这个时候将上述式子代入 “Score Function 和 Vector Field 本质上是同一回事” 所对应的 Gaussian nose 特例的关系式:
\[\begin{align} u_t^{\text{target}}(x\mid z) &= a_t \nabla \log p_t(x\mid z) + b_t x \\ u_t^{\text{target}}(x) &= a_t \nabla \log p_t(x) + b_t x \\ u_t^{\text{target}}(x\mid y) &= a_t \nabla \log p_t(x\mid y) + b_t x \label{eq:score_with_vector_field} \end{align}\]可以得到:
\[\begin{align} u_t^{\text{target}}(x\mid y) &= a_t \nabla \log p_t(x\mid y) + b_t x \\ &= a_t \left[\nabla_x \log p_t(y\mid x) + \nabla_x \log p_t(x) \right] + b_t x \\ &= a_t \nabla_x \log p_t(y\mid x) + \underbrace{a_t \nabla_x \log p_t(x) + b_t x}_{u_t^{\text{target}}(x)} \\ &= \underbrace{u_t^{\text{target}}(x)}_{\text{和 prompt $y$ 无关}} + a_t \nabla_x \log \underbrace{p_t(y\mid x)}_{\text{这里理解为 ``Classifier''}} \label{eq:classifier_guidence_intuition} \end{align}\]这里有个有趣视角的转化:没有 $y$ guidence $\iff$ prompt $y$ fixed。因此根据 Eq. ($\ref{eq:classifier_guidence_intuition}$) 可得到:
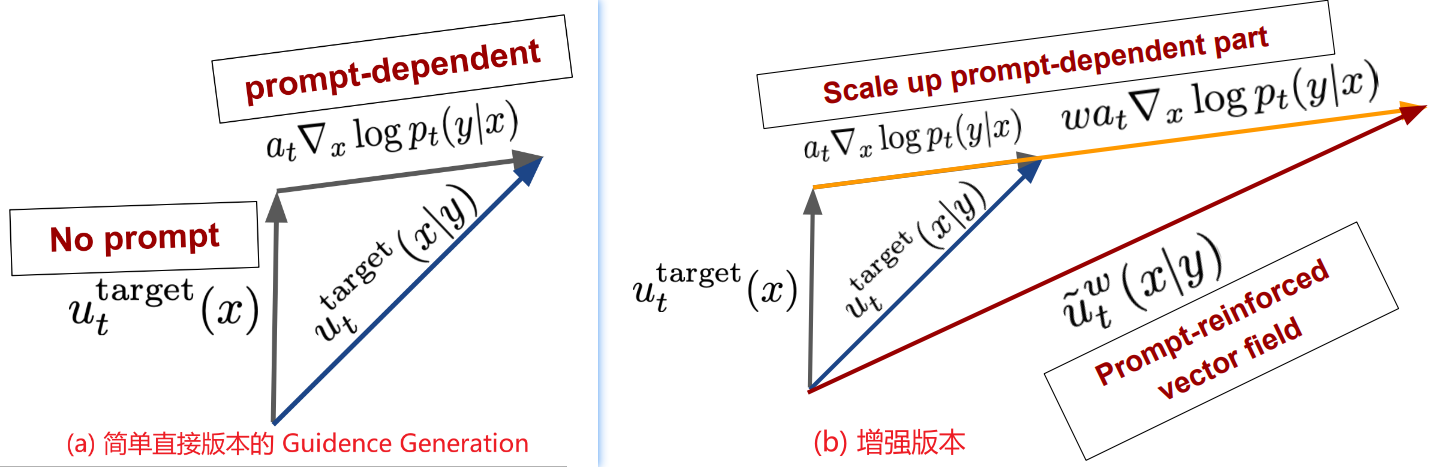
其中,图 (a) 形象体现出 Eq. ($\ref{eq:classifier_guidence_intuition}$) 的分解形式(也就是 “Classifier Guidence” 的来源),以及解释了为什么直接版本的生成质量不佳:prompt guidence 的强度不够;也因此自然得到图 (b) 中的改进:增大 prompt guidence 的权重!
但上述改进同样存在不足:需要分别训练 $u_t^\theta(x)$ 和 $p_t(y\mid x)$, 因此现今已经很少人使用这种形式了。
Classifier Free Guidence (CFG)
鉴于上述 Classifier Guidence 中的改进版本的不足,现在我们希望能够将 “Classifier” 给去掉。
Prompt-reinforced vector field: 根据上述图 (b), $\tilde{u}_t^w(x\mid y)=u_t^{\text{target}}(x) + w \alpha_t \nabla_x \log p_t(y\mid x)$.
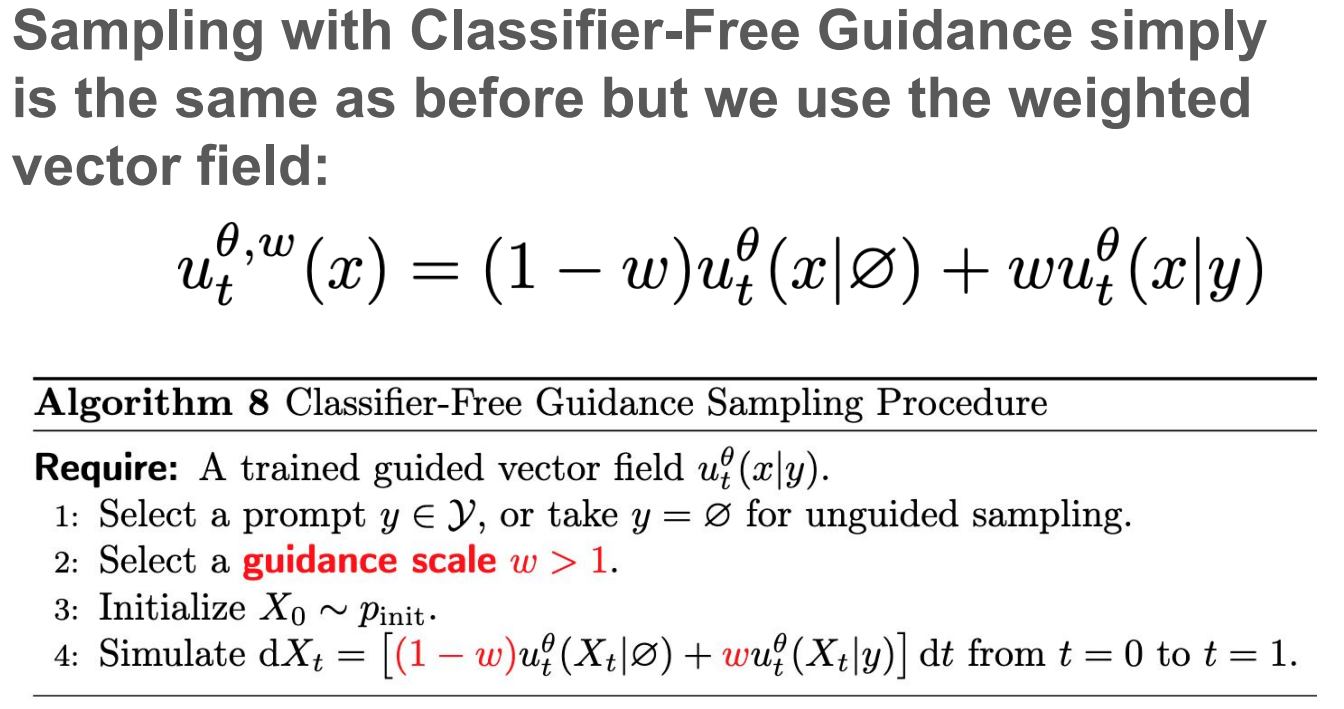
\[\begin{align} \tilde{u}_t^w(x\mid y) &=u_t^{\text{target}}(x) + w a_t \nabla_x \log p_t(y\mid x) \\ &=u_t^{\text{target}}(x) + w a_t \left[\nabla_x \log p_t(x\mid y) - \nabla_x \log p_t(x) + b_t x - b_t x \right] ——\text{根据 Eq. ($\ref{eq:guided_score_with_unguided_score}$)} \\ &=u_t^{\text{target}}(x) + w \left[\underbrace{(a_t \nabla_x \log p_t(x\mid y) + b_t x)}_{u_t^{\text{target}}(x\mid y)} - \underbrace{(a_t \nabla_x \log p_t(x) + b_t x)}_{u_t^{\text{target}}(x)} \right] ——\text{根据 Eq. ($\ref{eq:score_with_vector_field}$)} \\ &=(1-w)\cdot u_t^{\text{target}}(x) + w\cdot u_t^{\text{target}}(x\mid y). \end{align}\]现在我们摆脱了对 Classifier $p_t(y\mid x)$ 的依赖!这里需要训练两个 vector field 吗?答案是不需要。还记得刚才有个巧妙的视角转换吗?”没有 $y$ guidence” $\iff$ “prompt $y$ fixed”。因此可以将上述写为:
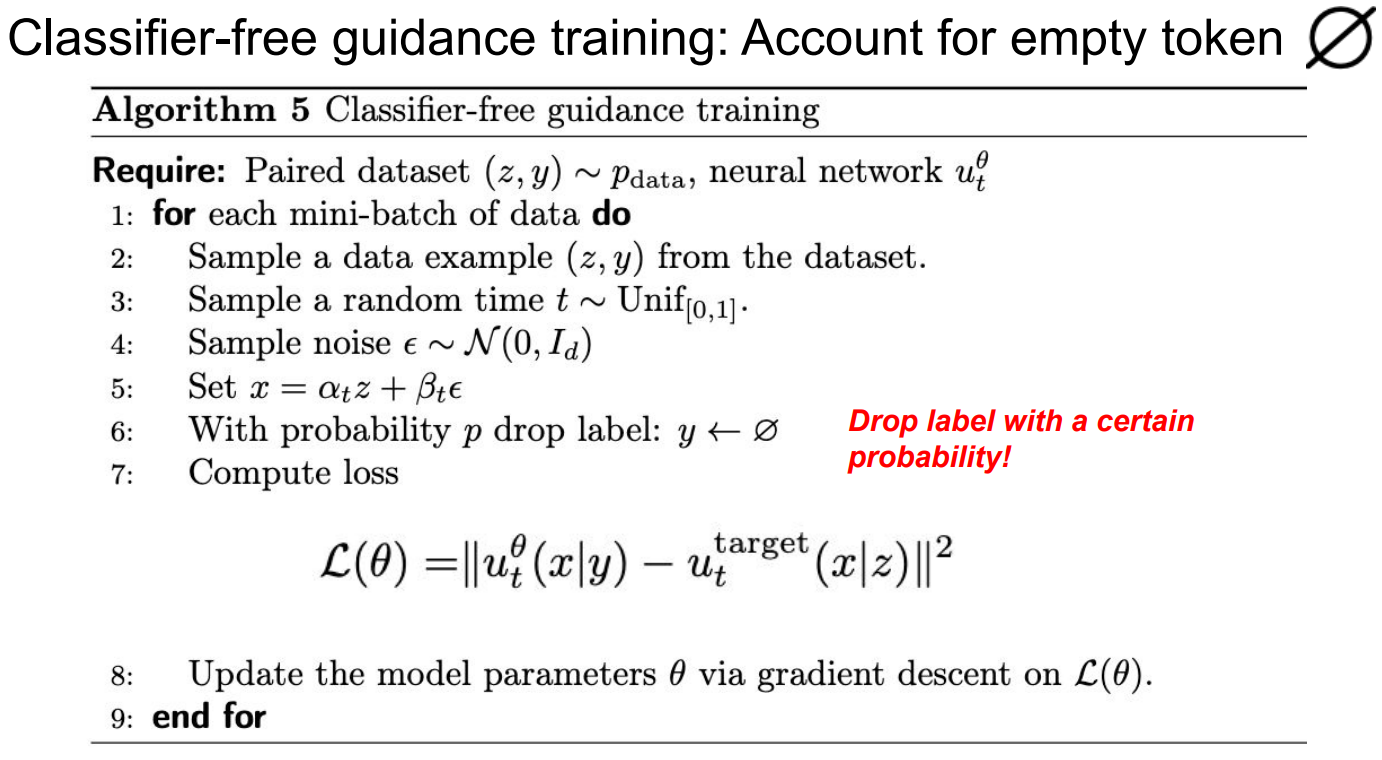
\[\begin{align} \tilde{u}_t^w(x\mid y) =(1-w)\cdot u_t^{\text{target}}(x\mid \varnothing) + w\cdot u_t^{\text{target}}(x\mid y). \end{align}\]现在我们可以仅训练一个 $u_t^\theta(x\mid \cdot)$ 去近似上式的 Prompt-reinforced vector field $\tilde{u}_t^w(x\mid y)$。只需要 $y\in \mathcal{Y}\cup \varnothing$ 即可。