对比学习论文串烧
本质思想: 利用数据对 (positive/negative pairs) 进行无监督/自监督学习, 在 feature space 上, 将同个类别的数据 (positive) 拉近, 不属于同个类别 (negative) 的推远.
自监督: 通过设计代理任务 (Auxiliary Task) 产生监督信号, 进而指导模型学习.
- 代理任务: 旨在帮助模型学习到更良好表征 (representation) 的不被重点关注的任务.
综上, 对比学习需要解决的问题也就很清晰了:
- 如何设计代理任务?
- 如何构造正负数据对? 即: 如何定义正数据对? 如何定义负数据对?
- 如何学习? 即: Contrastive Loss 实现 “拉近推远” 的效果? 更进一步, 如何设计 Contrastive Loss?
接下来笔者将对比学习领域的经典论文进行笔记整理, 其中知识点主要来自b站视频 对比学习论文讲解1, 对比学习论文讲解2; 同时还有: 笔者对额外相关材料的查阅以及对论文原文的粗浅理解. 沐神组织的这个读论文栏目虽然时间已比较久远, 但是质量非常高, 是非常不错的学习材料.
目录
InstDisc
如何设计代理任务?
该篇论文首次提出了个体判别任务. 该任务的核心思想是: 将每个独立个体作为一类进行分类任务.
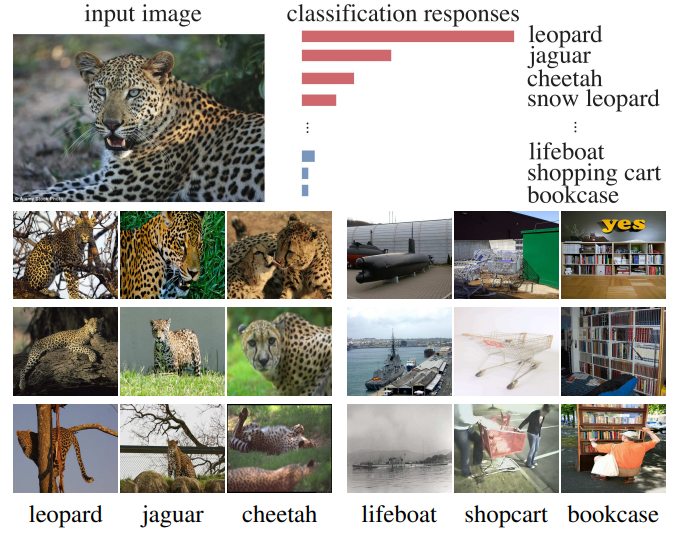
如上图所示, InstDisc 作者的 insight 是: 图片本身的相似性影响了分类器预测类别概率, 分类器预测类别的概率并不依赖于标签信息.
- 举个例子: 判断此时一张豹子照片的类别.
- 由于猎豹, 雪豹等豹类图片本身相似, logits 在这几类上分的概率也较高;
- 豹子和船, 手推车, 书架不相似, 自然 logits 分的的概率均较低.
标签依赖性剥离, 促使作者的目光自然延申至 unsupervised learning 领域, 聚焦于如何挖掘出图片本身的信息, 即输入本身的比较. 更进一步, 则是将每个输入作为类别进行比较, 这也是个体判别任务提出的思维链.
上述思维链仅是笔者对 InstDisc 工作的个人见解与整合.
现在, 我们基于 insight 推导出代理任务的形式. 接下来自然需要解决另外两个本质问题.
如何构造正负数据对?
考虑代理任务是个体判别任务, 其中正样本对 $\lbrace (\boldsymbol{v_i}, f_{i}) \rbrace_{i=1}^{n}$ 理解为: 前后时间步模型针对同一个输入得到的 feature; 负样本对 $\lbrace (\boldsymbol{v_i}, f_{j}) \rbrace_{j=1}^{m}, i \neq j, \forall i \in [1,n]$ 则表示: 针对第 $i$-th 输入 $\boldsymbol{v_i}$, 其余输入的 feature.
如何设计 Contrastive Loss?
鉴于传统 $\text{softmax}$ 操作:
\[\begin{align} P(i \mid \boldsymbol{v})=\frac{\exp(\boldsymbol{w}_i^{\top} \boldsymbol{v})}{\sum_{j=1}^n \exp(\boldsymbol{w}_j^{\top} \boldsymbol{v})}, \end{align}\]其中, $\boldsymbol{v}=f_{\theta}(x)$ 为输入 $x$ 的特征. $\boldsymbol{w}_i$ 表示第 $i$-th 类别所对应的分类器权重, 也可以理解为: 第 $i$-th 类别的原型 (prototype). 我们不难发现, 传统 $\text{softmax}$ 操作无法直接比较输入 ($x$, 也是 $\boldsymbol{v}$). 因此作者作出改进:
\[\begin{align} \label{eq:improved_softmax} P(i \mid \boldsymbol{v})=\frac{\exp(\boldsymbol{v}_i^{\top} \boldsymbol{v}/\tau)}{\sum_{j=1}^n \exp(\boldsymbol{v}_j^{\top} \boldsymbol{v}/\tau)}, \end{align}\]其中, $\boldsymbol{v}=f_{\theta}(x_i)=f_i$ 是 $\theta$ 在不断更新过程中, 模型 $f_{\theta}$ 输出的经过 $\ell_2$ 归一化的特征, 务必和直接从 Memory Bank 这个历史数组中得到的 $v_i$ 区分开; 温度系数 $\tau$, 是用来调控 logits 的分布形状, 需要结合具体任务调参. 最终得到理论损失函数:
\[\begin{align} \label{eq:ideal_loss} J(\theta) = -\sum_{i=1}^{n} \log P(i \mid f_{\theta}(x_i)) \end{align}\]在有监督学习中, $\text{softmax}$ 操作分母项中的 $n$ 是数据集类别数. 举个例子, 在 $\text{ImageNet}$ 上进行训练时, $n=1000$. 而在个体判别任务上, $n$ 不再是 $1000$, 而是恐怖的百万数量级, 这会导致 $\text{softmax}$ 操作极其敏感以及耗时耗力. 因此 InstDisc 在此处进行改进.
- 将多分类任务转化为多个二分类任务. 首先定义二分类概率 $h(i, \boldsymbol{v}) = \frac{P(i \mid \boldsymbol{v})}{P(i \mid \boldsymbol{v})+m P_{n}(i)}$, 其中 $P_{n}(i)\sim \frac{1}{n}$ 是噪声分布概率, $m=\frac{\text{noise samples}}{\text{data samples}}$. $h(i, \boldsymbol{v})$ 理解为: $\boldsymbol{v}$ 和给定的 $x_i$ 是正样本对还是负样本对; 而不再需要去判断 “$\boldsymbol{v}$ 对应哪一个 $x_i$”, 实现了从多分类 $\to$ 二分类的转换.
- 利用蒙特卡洛近似, 将 Eq. (\ref{eq:improved_softmax}) 中的分母项替换为: $\frac{n}{m}\sum_{k=1}^{m} \exp(v_{jk}^{\top} f_i / \tau)$, 其中 $f_i=f_{\theta}(x_i)$ 是第 $i$-th 图片的特征.
\(\begin{align} \label{eq:nce_loss} J_{NCE}(\theta) = -E_{P_d}[\log h(i, \boldsymbol{v})]- m\cdot E_{P_n}[\log (1-h(i, \boldsymbol{v}'))], \end{align}\) 其中, $P_d, P_n$ 分别表示 data, noise distribution. $\boldsymbol{v}$ 表示和 $x_i$ 对应的特征 (构成正样本对); $ \boldsymbol{v}’$ 表示和 $x_i$ 不相关的其他特征 (构成负样本对).
| 符号 | 全称 | 理解 | 对应样本 | 目标 |
|---|---|---|---|---|
| $E_{P_d}$ | Expectation over Data | 针对当前 batch 中正样本对的平均损失 | 当前图片 vs 它自己的特征 | 让相似度变高 |
| $E_{P_n}$ | Expectation over Noise | 针对当前 batch 中负样本对的平均损失 | 当前图片 vs 随机噪声特征 | 让相似度变低 |
在优化 Eq. (\ref{eq:nce_loss}) 的过程中, 模型学到的 $h(i, \boldsymbol{v})$ 会收敛到真实的数据比率. 通过数学推导 (参见 Gutmann & Hyvärinen, 2010), 可以证明:只要负样本采样足够多 (m 足够大), 通过优化这个二分类损失,模型间接地学习到了原本 Softmax 中的概率分布 $P(i \mid \boldsymbol{v})$.
笔者在此处对 Proximal Regularization 不作探讨, 其旨在缓解由于 “正样本数量少导致优化过程梯度波动剧烈” 问题. 和 MoCo 的 momentum encoder 思想相似, 不过约束的是模型更新前后的 feature $\boldsymbol{v}$.
CPC
由于笔者认为 CPC 的核心贡献在于 InfoNCE 的提出, 因此笔者首先将 InfoNCE 的来龙去脉以一家之言进行阐述分析. 最后再将 CPC 归纳进入对比学习的框架中, 即 CPC 是如何回答解决对比学习的三个本质问题.
痛点与直觉
痛点: 高维数据包含了太多底层的、局部的噪声. 比如,一张图片有成千上万个像素细节,但它的核心类别信息 (比如“这是一只猫”) 只占极少的信息量. 如果强制模型去精确重构每一个像素/波形,模型会把大量的计算力浪费在拟合无意义的局部噪声上,而忽略了全局的上下文 (Context) .
直觉: 作者提出,我们应该去学习那些在时间跨度上共享的、变化缓慢的全局特征 (Slow features) (比如语音中的音素、图像中的物体), 而不是去关注局部的细节.
因此,CPC 不直接在数据空间 (Data Space) 去建模 $p(x\mid c)$ ,而是将其映射到一个紧凑的隐空间 (Latent Space), 并通过最大化未来信号 $x$ 与当前上下文 $c$ 之间的互信息 (Mutual Information, MI), 迫使模型学到真正有用的高级语义表示.
\[\begin{align} \label{eq:mutualinformation} I(x; c) = \mathbb{E}_{p(x,c)} \left[ \log \frac{p(x|c)}{p(x)} \right] = \sum_{x,c} p(x, c) \log \frac{p(x|c)}{p(x)}, \end{align}\]
方法论
现在再一次明确, CPC 旨在最大化互信息 $I(x; c)$. 首先作者将目光由 Eq. (\ref{eq:mutualinformation}) 转向其中的关键因子 $\frac{p(x|c)}{p(x)}$, 定义其为密度比 (Density Ratio). 但是真实世界的概率分布 $p(x), p(x|c)$ 难以知晓, 我们仅有的是一堆数据. 因此作者需要解决的挑战转换成为: 如何仅使用数据样本, 直接估算出两个未知分布的密度比.
幸运的是, 该问题已被统计学家解决——Noise-Contrastive Estimation (NCE, 见 Eq. (\ref{eq:nce_loss})). 可惜的是, NCE 也存在其局限性: 需要显式知道噪声分布概率. 在 InstDisc 工作中, 作者人为设定噪声分布概率 $P_{n}(i)\sim \frac{1}{n}$ 是均匀分布.
鉴于此, CPC 作者对 NCE 进行升级, 提出了大名鼎鼎的 InfoNCE, 为后来诸如 MoCo, SimCLR, CLIP 等所有划时代对比学习模型不可动摇的基石.
\[\begin{align} \label{eq:infonce_loss} \mathcal{L}_{InfoNCE} = -\mathbb{E} \left[ \log \frac{f(x^+, c)}{f(x^+, c) + \sum_{j} f(x^-_j, c)} \right], \end{align}\]其中, $x^+, x^-$ 分别表示正样本和负样本. 在最小化的过程中, $f_{opt}(x, c) \propto \frac{p(x\mid c)}{p(x)}$. InfoNCE 摆脱了对概率分布的依赖, 且数学层面可证: 最小化 InfoNCE 本身,就在严格推高互信息的一个下界.
Theorem A.1 采样得到样本 $x$ 以及给定上下文信息 $c$, 有下述不等式成立: \(\begin{align} I(x; c) \ge \log(N) - \mathcal{L}_{InfoNCE}, \end{align}\)
其中 $N$ 是样本总数 (包括正负样本), $I(x; c)$ 是样本 $x$ 和上下文 $c$ 的互信息. 我们不难发现: 最小化 $\mathcal{L}_{InfoNCE}$ 等价于最大化 $\log(N)-\mathcal{L}_{InfoNCE}$, 从而理论层面保证推高互信息的下界.
$$ \begin{proof}
1. 定义数据生成过程 (概率模型)
已知正负样本: $x_{v} \sim p(x|c), x_{j} \sim p(x), j\neq v$. 所以整个样本集合 $X = {x_1, x_2, \dots, x_N}$ 联合概率分布就是各个样本概率乘积: $p(X \mid c, v) = p(x_v \mid c) \prod_{j \neq v} p(x_j)$. 又因为 $p(v \mid c)=\frac{1}{N}$ 以及链式法则 (基于条件概率的恒等式) 有: \(\begin{align} \label{eq:probability_model} p(X, c, v) &= p(c) \cdot p(v \mid c) \cdot p(X \mid c, v)\\ &= p(c) \cdot \frac{1}{N} \cdot \left[p(x_v \mid c) \prod_{j \neq v} p(x_j) \right] \end{align}\)
2. 将 InfoNCE 转化为 KL 散度与条件熵
观察不难发现, InfoNCE 正是交叉熵损失. 因此利用信息论中的性质: 交叉熵 = 信息熵 + KL 散度, 我们有: \(\begin{align} \mathcal{L}_{InfoNCE} = H(v | X, c) + \mathbb{E}_{X, c} \left[ D_{KL}( p(v|X,c) \parallel q_\theta(v|X,c) ) \right]. \end{align}\) 因为 KL 散度永远大于等于 0, 我们有: \(\begin{align} \label{ineq:1} \mathcal{L}_{InfoNCE} \geq H(v | X, c). \end{align}\) 随着最小化 InfoNCE 取得最小值, $\mathcal{L}_{InfoNCE} = H(v | X, c)$ 成立. 因此, 分析 InfoNCE 性质转换为分析其下界 H(v | X, c) 的性质.
3. 拆解 $H(v \mid X, c)$
直接计算 $H(v | X, c)$ 无从下手, 因此考虑利用性质: $H(v, X | c) = H(v | c) + H(X | v, c)$ 和 $H(v, X | c) = H(X | c) + H(v | X, c)$. 联立二者不难得到: \(\begin{align} H(v | X, c) = H(v | c) + H(X | v, c) - H(X | c). \end{align}\) 由于正样本的位置 $v$ 和上下文信息 $c$ 二者相互独立, 有: $H(v | c) = H(v)$. 又因为 $v$ 的选择是随机的, 因此认为是均匀分布, 所以有: $H(v) = \log N$. 代入得: \(\begin{align} \label{eq:3} H(v | X, c) = \log N + H(X | v, c) - H(X | c). \end{align}\) 接下来, 我们只需要计算 $H(X | v, c)$ 和 $H(X | c)$.
4. 计算 $H(X\mid v, c)$
由于正负样本生成过程互不干扰, 独立生成, 那么 “这一堆样本总共包含多少信息量 (不确定性)”, 自然就等于 “每个样本的信息量加起来”, 形式化表述: $H(X | v=i, c) = H(x_i | c) + \sum_{j \neq i} H(x_j)$. 不管 $v$ 取哪个位置, 上面这个和式里永远有 1 个 $H(x|c)$ 和 $N-1$ 个无条件边缘熵 $H(x)$. 因此对其求期望依然不变: \(\begin{align} H(X | v, c) = H(x | c) + (N - 1) H(x). \end{align}\) 很好, 现在 $H(X | v, c)$ 的计算也归结到 $H(X | c)$ 上. 我们的目标转化为: 计算 $H(X | c)$.
5. 计算 $H(X | c)$
求 $H(X | c)$ 也就是求 $H(X|c) = H(X) - I(X ; c)$. 因此目标再次发生转换: $H(X)$, 也就是 $p(X)$. 因为样本集 $X$ 的产生依赖于隐变量 $c$ 和 $v$, 但我们只想求 $p(X)$, 所以必须把所有可能的 $c$ 和 $v$的情况都 “积掉” (加和/积分). \(\begin{align} p(X) &= \sum_{v} \int_{c} p(X, c, v) \, dc \, \text{ (根据全概率公式)}\\ &= \sum_{i=1}^{N} \int_{c} \left[ p(c) \cdot p(v=i) \cdot p(X | c, v=i) \right] \, dc \, \text{ (根据 Eq. (\ref{eq:probability_model}))} \\ &= \sum_{i=1}^N p(v=i) \int_{c} p(c) \cdot p(X | c, v=i) \, dc \, \text{ (因为 $p(v=i)$ 与 $c$ 无关)} \\ &= \frac{1}{N} \sum_{i=1}^N \int_c p(c) p(x_i | c) \prod_{j \neq i} p(x_j) dc \, \text{ (展开 $p(X|c, v=i)$ 且 $p(v=i)$ 是均匀采样)} \\ &= \frac{1}{N} \sum_{i=1}^N \left( \prod_{j \neq i} p(x_j) \right) \underbrace{\left[ \int_c p(c) p(x_i | c) dc \right]}_{p(x_i)} \, \\ &= \frac{1}{N} \sum_{i=1}^N \left( \prod_{k=1}^N p(x_k) \right) \, \\ &= \prod_{k=1}^N p(x_k) \end{align}\) 在没有任何上下文信息 $c$ 的情况下, InfoNCE 构造的这 $N$ 个样本集合 $X$, 在统计学上等价于完全独立地从边缘分布 $p(X)$ 中抽出来的 $N$ 个样本. 既然 $p(X)$ 是 $N$ 个独立同分布的 $p(x)$,那么它的熵就是: $H(X) = N \cdot H(x)$. 进而得出结论: \(\begin{align} H(X | c) = H(X) - I(X ; c) = N \cdot H(x) - I(X ; c) \end{align}\)
6. 最终的代数拼装
现在,我们将步骤 4 和 步骤 5 的结果,代回到步骤 3 的公式 Eq. (\ref{eq:3}) 里: \(\begin{align} H(v | X, c) &= \log N + \underbrace{\big[ H(x | c) + (N - 1) H(x) \big]}_{\text{步骤 4}} - \underbrace{\big[ N \cdot H(x) - I(X ; c) \big]}_{\text{步骤 5}} \\ &= \log N + H(x | c) + N \cdot H(x) - H(x) - N \cdot H(x) + I(X ; c) \\ &= \log N + H(x | c) - H(x) + I(X ; c) \\ &= \log N - I(x ; c) + I(X ; c). \end{align}\) 现在将上述等式代入不等式 (\ref{ineq:1}) 可得: \(\begin{align} I(x ; c) \ge \log N - \mathcal{L}_{InfoNCE} + I(X ; c). \end{align}\) 最后因为任何变量之间的互信息都必然非负, 所以 $I(X ; c) \ge 0$ 成立. 我们可以安全地扔掉这个正数项, 从而摆脱对概率分布 $p(x|c)$ 和 $p(c)$ 的依赖, 最终得到一个更简洁明了的下界: \(\begin{align} I(x ; c) \ge \log(N) - \mathcal{L}_{InfoNCE} \end{align}\) \end{proof} $$
现在我们停下脚步, 回顾一下前面, 理清逻辑链:
\[\begin{align} \notag \text{最大化互信息} \xrightarrow{\text{互信息的数学定义}} \text{聚焦在密度比} \xrightarrow{\text{期望摆脱对分布概率的显式依赖}} \text{NCE} \xrightarrow{\text{NCE 还不够好}} \text{InfoNCE} \xrightarrow{\text{和互信息存在紧密关联}} \text{最大化互信息下界} \end{align}\]不难发现, 上述对于 InfoNCE 的阐述和理解, 恰好回答了 “CPC 如何设计 Contrastive Loss” 这一本质问题, 也对另外另外二者有所涉及. 笔者接下来更加具体地给出 CPC 对另外两个本质问题的回答.
如何设计代理任务?
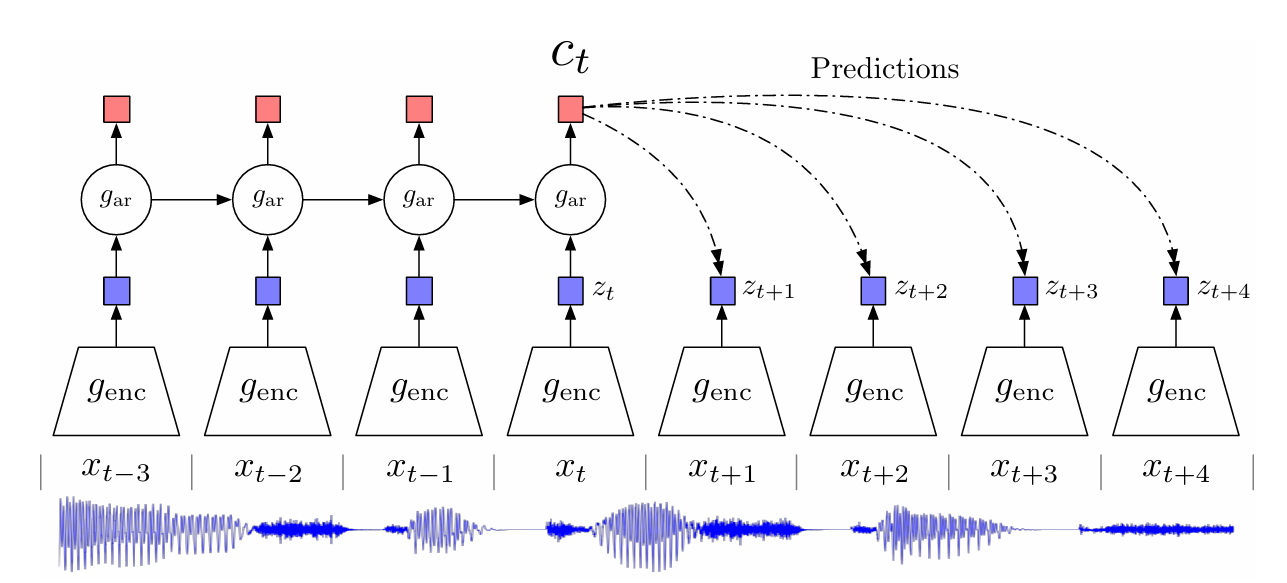
如上图所示. CPC 首先通过编码器 $g_{\text{enc}}$ 将 $x_{\leq t}$ 编码为 $z_{\leq t}$; 然后再用一个自回归模型 $g_{\text{ar}}$ 汇总上下文信息得到 anchor $c_{t} = g_{\text{ar}}(z_{\leq t})$. 作者认为, 在时间跨度上共享, 变化缓慢的全局特征 (Slow features) 是重要的. 因此, Slow features 成为了对比学习中的对比对象——正负样本, 对应的代理任务是: 衡量 $t$ 时刻和 $t+k$ 时刻的 feature 有多接近, 也就是 “共享/变化缓慢”.
形象理解则是, 给 “线索” $c_{t}$ 和想要知道的真相 $z_{t+k} = g_{\text{enc}}(x_{t+k})$ 的相似度评分, 看有多接近. CPC 原文使用了简单的 $\text{log-bilinear}$ 形式:
\(\begin{align} f_k(z_{t+k}, c_t) = \exp\big(z_{t+k}^\top W_k c_t\big), \end{align}\) 其中, $W_k$ 是一个可学习的矩阵,每一个预测步长 $k$ 有自己的 $W_k$.
如何构造正负数据对?
-
正样本 $x_{pos} \sim p(x\mid c)$: 在物理世界里, 未来的观测 $x$ 是由当前的上下文 $c$ 决定的 (或者高度相关的).
-
负样本 $x_{neg} \sim p(x)$: 负样本代表”干扰项”或”背景噪声”. 我们希望模型学会区分”与 $c$ 相关的未来”和”随机出现的其他数据”.
MoCo
将对比学习抽象为字典查找 (dictionary look-up):
-
正样本对:$\lbrace x_i^{\text{anch}}, x_i^{\text{pos}} \rbrace$; 负样本对:$\lbrace x_i^{\text{anch}}, x_j^{\text{neg}} \rbrace,\ \forall i \neq j$.
-
将 $x_i^{\text{anch}}$ 视作查询 (query): $x^{\text{query}}$; 将正/负样本组织成为字典 (的 key): $\lbrace x_i^{\text{key}} \rbrace_{i=0}^{N}$.
| 核心假设 | 对假设的直觉 | MoCo 做出的对应改进 |
|---|---|---|
| 字典要大 | 足够充分的数据确保对原始类别的特征涵盖 | 使用队列存储 key fearture |
| 编码器要一致/相近 | 保证了对比过程中的 “可比性” | 引入动量编码器提取 key fearture |
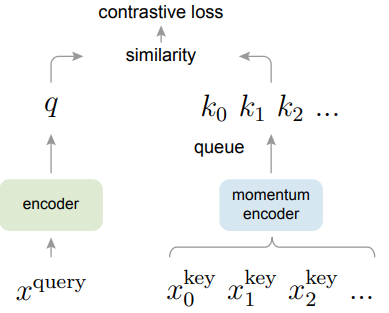
接下来顺一下思维链:
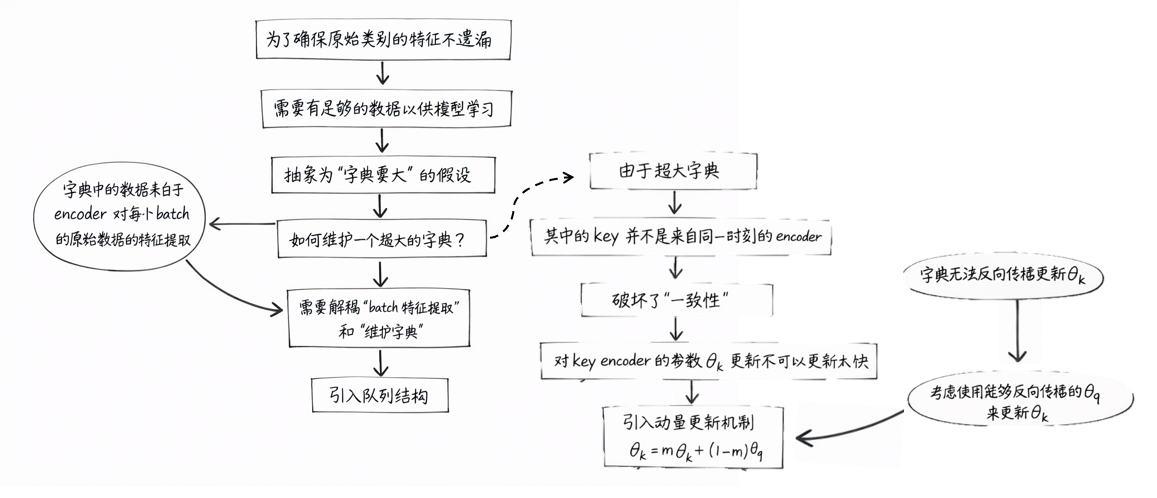
接下来就是将改进塞入对比学习的框架, 即解决三种本质问题:
-
设计代理任务: MoCo 和 InstDisc 保持一致, 选择个体判别任务.
-
构造正负数据对: 由代理任务自然可得, 正样本对是同张图片的多个变换; 负样本对则是不同图片. 在原文中还涉及到锚点 (Anchor), 其表示的是原始图像.
-
设计 Contrastive Loss: MoCo 基于 dictionary look-up 抽象, 指出 Contrastive Loss 的设计原则即为: whose value is low when $q$ is similar to its positive key $k_+$ and dissimilar to all other keys (considered negative keys for $q$). 最终 MoCo 选择了 InfoNCE 损失函数, 如下所示.
详细分析见 CPC 的 分析.
SimCLR
SimCLR 顾名思义, 想法简单高效!
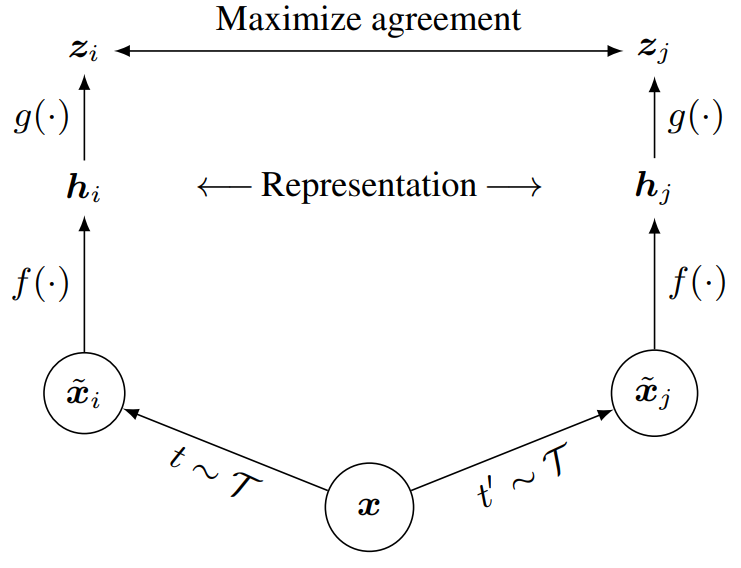
其给笔者比较有启发的点是: 在最后引入了一个 projection head $g(\cdot)$ (其实是一个 MLP, 后经 SimCLR v2 实验发现, 2 层效果最佳), 大幅提升了无监督预训练模型在下游任务上的表现. 并且该提升已经被后续众多工作验证. 其提升机理似乎是个有意思, 可挖掘的 topic?
接下来, 笔者总结一下 SimCLR 是如何回答对比学习的三个本质问题的?
如何设计代理任务?
同样使用的是 InstDisc 所提及的个体判别任务 (Instance Discrimination). 沿着对比学习的发展脉络, 笔者发现代理任务基本已经确定下来, 成为对比学习新工作的基本组件了, 较少在代理任务上进行创新. 而更多的工作将精力放在了对正负样本对的构造上.
如何构造正负数据对?
如图所示, 将每个输入 $x$ 进行两次数据增强所得到的 $\widetilde{x_i}, \widetilde{x_j}$ 组织成为一个正样本对; 将和其余输入所增强得到的数据均视作负样本.
让我们来拆解一下:
- 假设批次大小为 $N$ (原始图像数), 增强后样本数为 $2N$. 相同原始图像增强的两个样本构成 $1$ 个正样本对 $\lbrace (\widetilde{x_i}, \widetilde{x_j}) \rbrace_{k=1}^{N}$, 因此总共有 $N$ 个正样本对.
- 以 $\widetilde{x_i}$ 为 Anchor,$\widetilde{x_j}$ 为正样本。此时负样本是剩余的 $2N-2$ 个样本。这产生了 $2(N-1)$ 个负样本对.
- 以 $\widetilde{x_j}$ 为 Anchor,$\widetilde{x_i}$ 为正样本. 此时负样本也是剩余的 $2N-2$ 个样本. 这又产生了 $2(N-1)$ 个负样本对.
如何设计 Contrastive Loss?
SimCLR 提出了新的损失函数: NT-Xent (Normalized Temperature-scaled Cross Entropy Loss). 笔者认为和 InfoNCE 没有本质区别, 仅要求: $z_i, z_j$ 是经过 $\ell_2$ 归一化的且使用余弦相似度替代原本的单纯内积计算.
\[\begin{align} \ell_{i,j} = - \log \frac{\exp(\text{sim}(z_i, z_j)/\tau)}{\sum_{k=1}^{2N} \mathbb{1}_{[k \neq i]} \exp(\text{sim}(z_i, z_k)/\tau)}, \end{align}\]其中, $\operatorname{sim}$ 表示余弦相似度; $\ell_{i, j}$ 表示以 $\widetilde{x_i}$ 作为 anchor, $\widetilde{x_j}$ 为正样本来计算损失. 由于针对同一个输入, 有两个 anchor, 因此总损失函数有两部分:
\[\begin{align} L = \frac{1}{2N} \sum_{k=1}^{N} [\ell_{2k-1, 2k} + \ell_{2k, 2k-1}]. \end{align}\]这里之所以能够保证 $\widetilde{x_{2k-1}}, \widetilde{x_{2k}}$ 能够构成正样本对, 是因为在数据增强阶段, SimCLR 将第 $k$-th 样本增强后的索引分别映射为 $2k-1, 2k$.
笔者这里不过多赘述 MoCo v2 和 SimCLR v2, 由于并没有较为本质的启发性观点, 更多的是 MoCo 和 SimCLR 彼此之间的借鉴以及工程上的 trick 叠加.
SWaV
InfoMin
这里的 “Min” 表示的是并不是最小化; 而是适量地最大化互信息.
BYOL
负样本的作用是什么, 我们为什么不能抛弃掉负样本呢?
我们不妨考虑一下只有正样本的情况. 那么此时的损失函数则是会将所有正样本尽可能接近; 进而导致了 “模型坍缩” 的情况发生, 即: 模型对所有输入输出相同的预测输出——这正是仅有正样本的捷径解.
那么我们能仅有正样本进行特征学习吗? BYOL 给出了肯定的答案.
BYOL 初期被社区质疑并没有完全抛弃负样本, 而是由于 BN, 隐式利用了负样本进行学习. 因此 BYOL 作者又出了一篇工作进行对线.
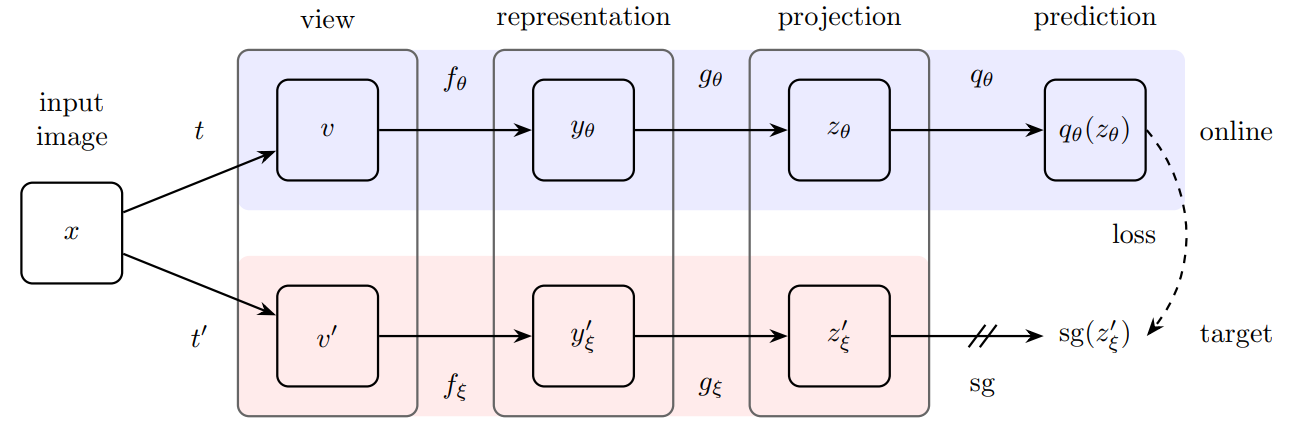
其本质是在 SimCLR 上进行延申拓展.
- 新增 projection head $q_{\theta}$.
- 将代理任务设置为: 预测得到的 $q_{\theta}(z_{\theta})$ 有多接近已经停止梯度反传的 $z_{\xi}’$. 因此 BYOL 选用的损失函数则是简单的 $MSE$.
SimSiam
何凯明大佬再次出手, 尝试一统对比学习领域.
CLIP
不定时更新中…
Reference
[1] InstDisc 原文
[2] CPC 原文
[3] MoCo 论文精读
[4] MoCo 原文
[5] 对比学习论文串讲
[6] SimCLR 原文
[7] SWaV 原文