前言
前言不再赘述. 详见 熵家族 v1. 学习资料见 Reference.
互信息
现在我们对 “熵” 具备了较为充分的认知. 我们同样尝试 “自己构建” 出什么是 “互信息 (Mutual Information, MI)”. 由于学习资料发生变化, 因此符号定义作出修改: 信息熵 $S\to H$.
现在思考这样的问题: 如果我观测了变量 $X$, 我能获得多少关于变量 $Y$ 的信息量?
我们首先翻译一下上述问题. 首先, “信息量” 自然可以用 “熵” 进行表述; “获得多少” 表示我们的目标形式是两项相减; 此外, “观测了 $X$” 则说明我们需要用条件熵来建模 “减数”.
因此, 互信息自然可以定义出来:
\[\begin{align} I(Y;X)=H(Y)-H(Y\mid X), \end{align}\]再结合 (条件) 熵的性质 推导可得互信息的对称性:
\[\begin{align} I(Y;X) &=H(Y)-H(Y\mid X) \\ &=H(Y)-(H(X, Y)-H(X)) \\ &=H(X)-H(X\mid Y) \\ &=I(X;Y). \end{align}\]- 如果 $X$ 和 $Y$ 完全独立 (比如 “今天的天气” 和 “我扔的硬币”), 知道 $X$ 对预测 $Y$ 没有任何帮助, 互信息为 0.
- 如果 $X$ 和 $Y$ 完全相关 (比如 “英文文章” 和 “对应的中文翻译”), 知道 $X$ 就能完全确定 $Y$, 互信息最大.
这里笔者在学习 $I(Y;X)$ 和 $H(Y\mid X)$ 过程中, 感觉都是 “增量”. 因此下面尝试进行区分:
视角 A: 过程视角 (学习的过程)
这是我们谈论 “互信息” 或 “信息增益” 时通常的语境.
- 场景: 你原本不知道 $X$ (状态 $H(X)$) , 现在我告诉你 $Y$.
- 变化: 你的不确定性发生了改变.
- 公式: $\text{变化量} = \text{初始状态} - \text{结束状态} = H(X) - H(X\mid Y)$.
- 结果: 互信息 $I(X;Y)$ 代表了你 “学到了多少”. 这才是真正的 “增量” .
视角 B: 结构视角 (信息的构成)
这是讨论条件熵 $H(X\mid Y) = H(X,Y) - H(Y)$ 的语境.
- 场景: 我们不是在学习, 而是在拆分一个整体. 我们手里有一个包含 $X$ 和 $Y$ 的系统 $H(X,Y)$.
- 操作: 我们把属于 $Y$ 的那部分信息 $H(Y)$ 剔除出去.
- 公式: $\text{剩余部分} = \text{整体} - \text{剔除部分} = H(X,Y) - H(Y)$.
- 结果: 条件熵 $H(X\mid Y)$ 代表的是 “剩下的那一块”.
最大似然估计 (MLE)
在进入 KL 散度之前, 笔者复习一下何为 “最大似然估计”.
其核心思想是: 既然这件事发生了, 那么它大概率是由那个最容易让它发生的参数导致的. 遵循的是 “所见即所得” 的哲学: 既然事实 (数据) 发生了, 我们就应该完全相信事实, 选择让事实发生概率最大的那个模型. 其估计的便是: 参数!
举个通俗的例子: 假设 A: 隔壁住着一位钢琴家. 假设 B: 隔壁有一只会乱按琴键的猴子. 显然, 假设 A (钢琴家) 能最大程度地解释 “听到钢琴声” 这个现象. 所以根据 MLE 原则, 你会推断隔壁住的是钢琴家.
这和有监督学习的场景非常贴合! 笔者不知道神经网络在有监督学习上的成功是否可由最大似然估计所保证, 但是二者的契合程度非常高. 我们已知事件发生 (输入+标签已知), 期待找到最佳的参数.
形式化表达
假设我们观测到了一组数据 $X = {x_1, x_2, …, x_n}\sim p$, 我们要使用带有参数 $\theta$ 的概率分布 $q$ 去逼近这些数据的真实概率分布 $p$. 注意这里的 $x_i=\lbrace x_{i}^{input}, x_{i}^{label} \rbrace$. 我们定义似然函数 $L(\theta)$:
\(\begin{align} L(\theta) = q(X \mid \theta) = q(x_1 \mid \theta) \cdot q(x_2 \mid \theta) \cdot ... \cdot q(x_n \mid \theta), \end{align}\) 这里的连乘的原因非常直观: 找到参数 $\theta$ 使得 $X$ 同时符合观测. 注意这里的理解:
- 在概率里, $\theta$ 是已知常数, $X$ 是变量.
- 在似然里, $X$ 是已知常数 (数据已观测到), $\theta$ 是变量.
我们在寻找让 $q(X \mid \theta)$ 最大的那个 $\theta$. 因为数据点很多, 直接乘概率值 (通常小于 1) 会导致数值极小 (下溢出), 且乘法求导麻烦. 所以我们取对数, 将乘法变加法:
\[\begin{align} \ell(\theta) = \log L(\theta) = \sum_{i=1}^{n} \log q(x_i \mid \theta), \end{align}\]综上, MLE 的目标就是:
\[\begin{align} \hat{\theta}_{MLE} = \arg \max_{\theta} \sum_{i=1}^{n} \log q(x_i \mid \theta), \end{align}\]
KL 散度
KL 散度, 也称为相对熵. (这也是笔者将该系列命名为 “熵家族” 的原因hhh). 其量化了当我们使用带有参数 $\theta$ 的分布 $q$ 来近似真实概率分布 $p$ 时, 所损失的信息.
\(\begin{align} D_{KL}(p \mid \mid q) &= \sum_{x} p(x)\log\frac{p(x)}{q(x\mid \theta)} = \mathbb{E}_{x\sim p}\Bigl[ \log \frac{p(x)}{q(x\mid \theta)} \Bigr] \\ &=\sum_{x} p(x)\bigl(\log p(x)-\log q(x\mid \theta)\bigr) \\ &=\sum_{x} p(x)\log p(x) - \sum_{x} p(x)\log q(x\mid \theta) \\ &=-H(p)\underbrace{-\sum_{x} p(x)\log q(x\mid \theta)}_{\text{定义为交叉熵 (Cross Entropy) } H(p,q)}, \end{align}\) 其中, $p, q$ 均是离散概率分布.
深入解构 KL 散度的最小化
KL 散度在机器学习, 深度学习领域被大量运用, 主要运用形式是最小化 KL 散度. 那么其本质是什么呢? 接下来笔者将构建出最优化问题, 并尝试不断简化以剥离出其本质.
\(\begin{align} \min_{\theta} D_{KL}(p \mid \mid q) &\Longleftrightarrow \min_{\theta} \Bigl(-H(p)-\sum_{x} p(x)\log q(x\mid \theta)\Bigr) \\ &\Longleftrightarrow \min_{\theta} \Bigl(-\sum_{x} p(x)\log q(x\mid \theta)\Bigr) \\ &\Longleftrightarrow \max_{\theta} \Bigl(\sum_{x} p(x)\log q(x\mid \theta)\Bigr) \\ &\Longleftrightarrow \max_{\theta} \mathbb{E}_{x\sim p} \Bigl[\log q(x\mid \theta)\Bigr], \end{align}\) 其中, 上述等价中, 不难发现 $H(p)$ 仅与观测值的真实分布 $p$ 有关; 真实分布是静态的 , 因此其为常数, 直接丢掉.
这里笔者联想到, 无监督学习中非常常见的 “熵最小化” 这一大类方法. 该方法实际上是 $\min_{\theta} H(f(X\mid \theta))$, 其中, $f(X\mid \theta)$ 表示的是模型对于输入 $X$ 的 logits.
很好, 到这里, 我们发现一个问题: $X\sim p$ 这里的 $p$ 我们无法得知. 我们知道的是仅是 $p$ 的近似估计 $\tilde{p}$. 幸运的是, 在现如今绝大部分研究中, 观测值 $X$ 是大量的. 假设有 $N$ 个观测, 我们使用大数定理有:
\[\begin{align} \frac{1}{N}\sum_{i=1}^{N} \log q(x_i\mid \theta) \longrightarrow \mathbb{E}_{x\sim p} \Bigl[\log q(x\mid \theta)\Bigr]. \end{align}\]将其替换掉上述最优化问题, 得到: \(\begin{align} \min_{\theta} D_{KL}(p \mid \mid q) \Longleftrightarrow \max_{\theta} \frac{1}{n}\sum \log q(x_i\mid \theta). \end{align}\)
深刻含义: 最小化模型分布 $q$ 与真实数据分布 $p$ 之间的 KL 散度其实就是在做 MLE.
KL 散度的非对称性讨论
假设真实分布 $p$ 是一个正态分布 (数据集中在中心), 而我们的近似分布 $q$ 是一个均匀分布.
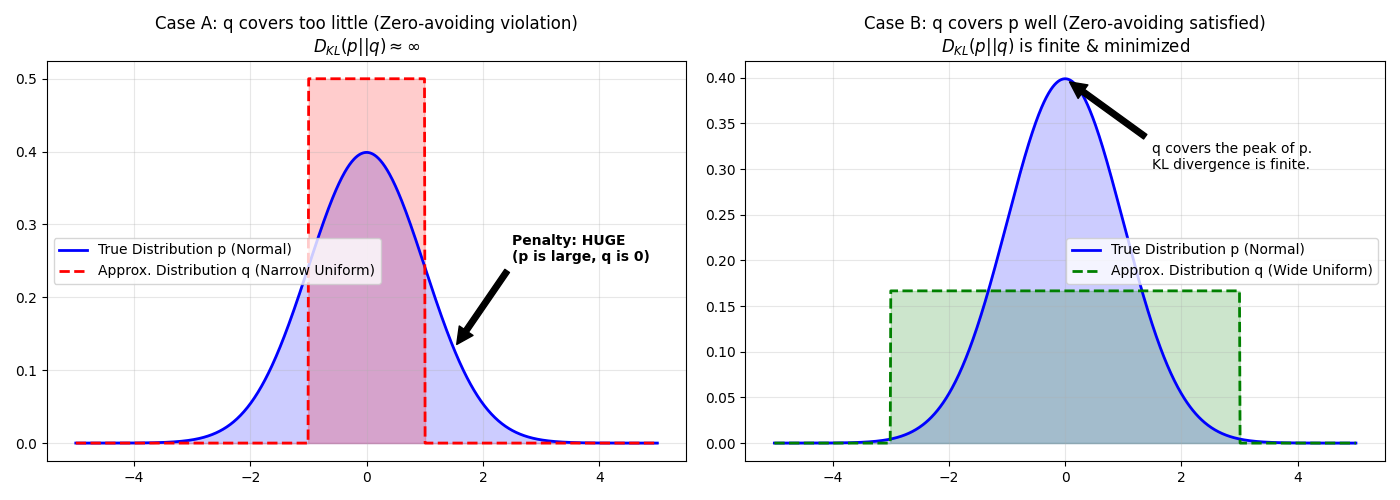
左图 (情况 A - 覆盖不足):
- 现象: 蓝色的正态分布曲线 $p$ 在中心很高, 但红色的均匀分布 $q$ (区间 $[-1, 1]$) 太窄了.
- 问题所在: 看 $x=1$ 到 $x=2$ 这个区域. 真实分布 $p(x)$ 在这里依然有显著的概率值, 但是近似分布 $q(x)$ 在这里直接等于 0.
- KL 散度计算: 由于在 $p(x) > 0$ 的地方 $q(x) = 0$, 公式中的 $\log(p/q)$ 分母为 0, 导致 KL 散度趋向于无穷大.
- 结论: 这是正向 KL 散度最无法容忍的情况. 模型会受到巨大惩罚, 因此优化过程会强迫 $q$ “拓宽”自己, 去覆盖这些区域.
右图 (情况 B - 覆盖充足):
- 现象: 绿色的均匀分布 $q$ (区间 $[-3, 3]$) 比较宽.
- 优势: 在 $p(x)$ 比较大的核心区域 (例如 $x \in [-2, 2]$) , $q(x)$ 始终大于 0.
- 代价: 虽然在 $x$ 很大的地方 (例如 $x=4$) , $p(x) \approx 0$ 而 $q(x) > 0$, 但这并不违反正向 KL 的规则. 因为公式权重是 $p(x)$, 既然 $p(x) \approx 0$, 那么这一项乘积 $p(x) \log(p(x)/q(x)) \approx 0$, 惩罚几乎为零.
- 结论: $q$ 宁可覆盖一些不必要的区域 (“Zero-avoiding”) , 也不敢漏掉任何 $p$ 存在的区域.
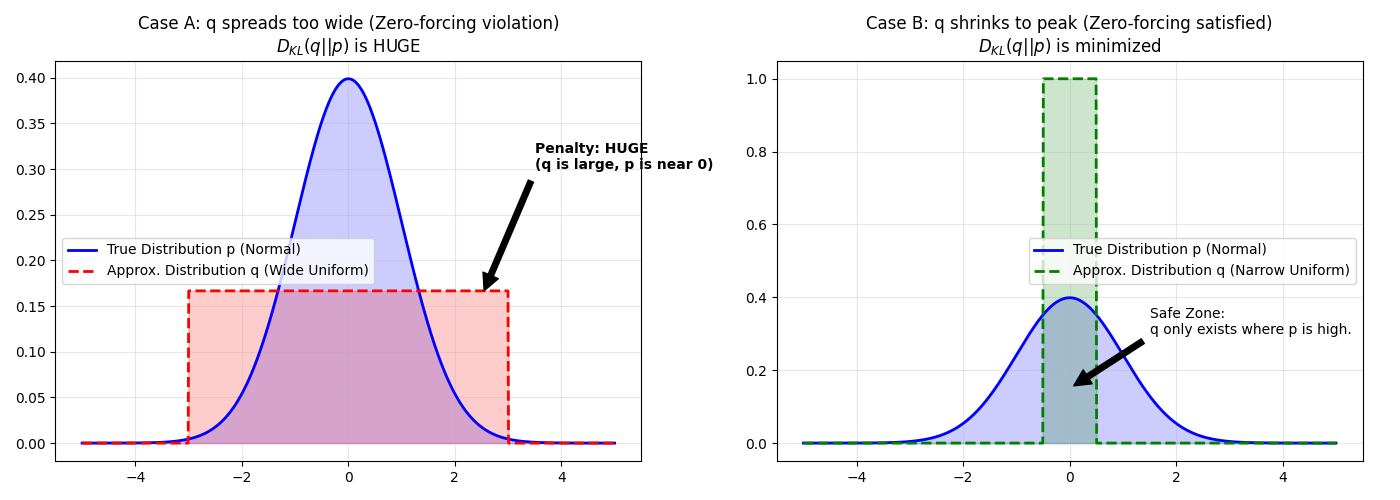
左图 (情况 A - 盲目扩张):
- 现象: 红色的均匀分布 $q$ 试图做一个“好人”, 想把 $p$ 包进去, 结果区间 $[-3, 3]$ 设得太宽了.
- 问题所在: 请注意 $x$ 轴两侧 (例如 $x=2.5$ 处). 此时真实分布 $p(x)$ 已经衰减到接近 0 (蓝色曲线贴地) , 但模型分布 $q(x)$ 依然有一个固定的高度 (红色矩形).
- KL 散度计算: 根据公式, 我们计算 $q(x) \log (q(x)/p(x))$. 因为 $p(x) \to 0$, 分母趋向 0, 对数项趋向负无穷, 整体趋向正无穷. 即使 $q(x)$ 值不大, 但在这些边缘区域, 惩罚也是毁灭性的.
- 结论: 反向 KL 散度极度反感 $q$ 在 $p$ 不存在的地方“无中生有”. 这就是为什么说 $q$ 不敢贸然覆盖.
右图 (情况 B - 收缩策略):
- 现象: 绿色的均匀分布 $q$ 变得非常胆小, 只敢待在 $x \in [-0.5, 0.5]$ 这个极小的范围内.
- 优势: 在这个狭窄范围内, $p(x)$ 非常大. 这就避开了 $p(x) \approx 0$ 的雷区.
- 代价: 虽然 $q$ 遗漏了 $p$ 在 $[-1, -0.5]$ 和 $[0.5, 1]$ 等区域的概率质量, 但这在反向 KL 的惩罚机制下是可以接受的 (因为权重要求是 $q(x)$, 既然 $q$ 在那些地方是 0, 那么 $p$ 是多少都无所谓).
综上分析, 性质总结如下:
| 特性 | 正向 KL 散度 ($p \parallel q$) | 反向 KL 散度 ($q \parallel p$) |
|---|---|---|
| 求和权重 | 数据真实分布 $p(x)$ | 模型习得分布 $q(x)$ |
| 惩罚项情况 | $p(x) > 0$ 的地方, $p(x)$ 太小 | $q(x) > 0$ 的地方, $p(x)$ 太小 |
| 优化 $q$ 行为 | Zero-avoiding (避开零值): $q$ 极力避免在 $p$ 存在的区域取值为 0, 因此会试图尽量覆盖 $p$. | Zero-forcing (强制归零): 试图同时覆盖多个峰时, 为了避免 $q$ 在中间的低概率区 ($p(x)\approx 0$) 分配质量从而招致惩罚, $q$ 往往只会选择其中一个峰进行覆盖. |
| 分布形态 | 覆盖: 倾向于覆盖所有模式, 高估方差 | 收缩: 倾向于塌缩到一个模式, 低估方差 |
| 多峰分布表现 | $q$ 会试图覆盖所有峰 (平均化) | $q$ 会只选一个峰 (模式寻找 Mode Seeking) |
| 典型应用 | 最大似然估计 (MLE), 交叉熵损失 | 变分推断, 强化学习策略优化 |
为了兼顾二者性质 (zero-avoiding/zero-forcing), 也存在工作使用对称化之后的 KL 散度作为损失函数:
\[\begin{align} D(p,q) &=D_{KL}(p\mid \mid q) + D_{KL}(q\mid \mid p) \end{align}\]
互信息与 KL 散度
现在我们有了两个重要概念: 互信息以及 KL 散度. 那么二者有关联吗? 若有, 关联又是什么呢? 下面笔者给出答案: 二者存在紧密关联, 互信息等价于 “边缘分布乘积” 与 “真实联合分布” 之间的 KL 散度.
\[\begin{align} I(Y;X) &=H(Y)-H(Y\mid X) \\ &=-\sum_y p(y)\log p(y)-\Bigl[-\sum_x \sum_y p(x, y)\log p(x, y)+\sum_x p(x)\log p(x) \Bigr] \\ &=-\sum_x \sum_y p(x, y)\Bigl[\log p(y)- \log p(x, y)+ \log p(x) \Bigr] \\ &=\sum_x \sum_y p(x, y)\Bigl[\log \frac{p(x, y)}{p(x) p(y)}\Bigr] \\ &=D_{KL}\bigl(p(x,y)\mid \mid p(x)p(y) \bigr). \end{align}\]交叉熵
在前文 KL 散度的推导中, 我们已经得到了交叉熵.
\[\begin{align} H(p,q) = - \sum_x p(x)\log q(x\mid \theta). \end{align}\]也已经推导出 “信息熵”, “交叉熵”, “KL 散度” 三者间的关系.
\[\begin{align} D_{KL}(p \mid \mid q)=-H(p) + H(p, q). \end{align}\]当 $p$ 是确定的分布时, $H(p)=0$. 因此最小化 $H(p, q)$ 等价于最小化 $D_{KL}(p \mid \mid q)$.
总结
好了, 现在我们可以稍作修正, 停下脚步回顾这一段路程, 并在深度学习语境下解读: 在有监督学习中, 最小化交叉熵损失 $\Longleftrightarrow$ 最小化 KL 散度 $\Longleftrightarrow$ 最大似然估计. 即: 寻找 $\theta^*$, 使得模型的分布 $q$ 尽可能接近数据的真实分布 $p$.
特殊的, 最大化特定对象的互信息 $\Longleftrightarrow$ 最小化特定对象的 KL 散度. 我们可以通过巧妙构造所求对象, 确保最优化过程的 “等价性” 传递到 “最大似然估计”, 进而确保针对 $\theta$ 进行优化.
举个例子, 在对比学习领域中, CPC 的本质思想就是去最大化特定对象的互信息. 最终 CPC 构造出 InfoNCE 损失函数, 并理论证明: 最小化 InfoNCE $\Longleftrightarrow$ 最大化互信息下界. 详见 “对比学习论文” 博客.
后续计划
笔者将所接触到的与熵相关内容基本囊括到一起, 组织成为: 熵家族 v1以及当前文章 (熵家族 v2), 但是依然存在遗漏, 主要是在特定领域中熵的应用, 如: Test-Time-Adaptation 中的以 TENT 为代表的 Minimize Entropy 算法; 强化学习 (Reinforce Learning, RL) 针对策略熵的算法; 熵坍塌等现象解释……
后续笔者将随缘更新 “熵家族” 系列, 希望该系列能够帮助到大家!
Reference
[1] 信息论基础: 从熵到KL散度
[2] “熵” 不起: 从熵、最大熵原理到最大熵模型 (二)
[3] TENT 原文